검색 메타데이터는 실제 콘텐츠의 사실에서 만들기
본문·화면·JSON-LD를 같은 정보로 만들고 없는 값을 합성하지 않는 원칙.
이 글의 목차
검색 메타데이터는 실제 콘텐츠의 사실에서 만들기
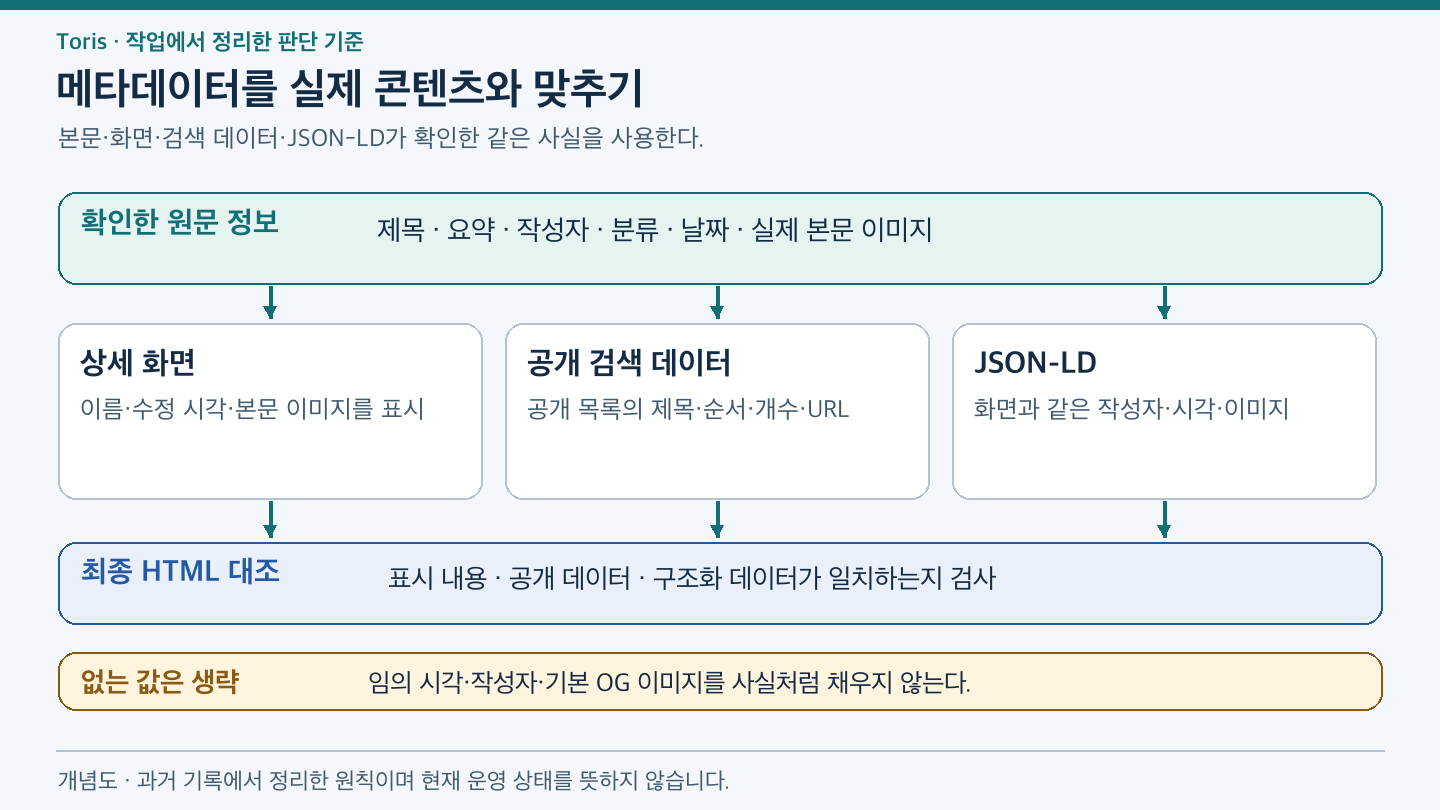
확인한 원문 정보를 공유하고 최종 출력과 대조하는 메타데이터 개념도.
내가 겪은 상황
2026년 10월 Codex로 블로그 구조화 데이터를 손볼 때 근거 없는 수정일과 단어 수를 제거하고, 실제 본문에 있는 이미지를 연결했다. 이미지가 없는 글에 정보를 추가할 때도 본문을 설명하는 이미지를 먼저 실제로 추가한 다음 JSON-LD에 연결했다.
내가 선택한 방법
제목·요약·작성자·분류·날짜·이미지의 원본을 먼저 확인한다. 화면과 검색 데이터와 JSON-LD가 같은 입력을 쓰게 하고, 최종 HTML의 표시 내용과 대조한다. 목록의 순서·개수·URL도 실제 공개된 문서 목록에서 만든다.
다음에도 쓸 기준
경고를 없애기 위해 알 수 없는 사실을 채우지 않는다. 수정일에 날짜만 있으면 임의 시각이나 시간대를 붙이지 않고, 작성자를 모르면 저장소 소유자를 대신 넣지 않는다. 본문 이미지가 없으면 사이트 기본 OG 이미지를 문서 이미지로 주장하지 않는다.
정확한 정보를 새로 제공하려면 원문과 화면에 실제로 추가하고 그 값으로 메타데이터를 만든다. 작성자와 수정 시각도 명시적으로 확인한 값만 연결한다. 로컬 정합성 검사와 검색 서비스의 구조화 데이터 검사는 각각 결과를 남긴다.
적용 한계
검증 도구의 통과는 검색 노출을 보장하지 않는다. 이 노트의 과거 검증 결과를 현재 사이트의 색인 상태로 읽지 않는다. 최초 발행일과 최근 수정일도 서로 대신할 수 없다.
관련: AI 작업 기록의 실행 앱과 중계 경로를 구분하기 · 완료라고 말하기 전에 검증한 단계를 나누기 · Toris의 작업 기록에서 정리한 암묵지