Hy4 Flash 가중치 공개, 220B를 12B로 돌리는 법
텐센트 Hy4 Flash 가중치가 11월 17일 공개됐다. 전체 220B 중 토큰당 12B만 활성화하고, OpenRouter 가격은 입력 $0.035·출력 $0.1405다. vLLM·SGLang으로 내 서버에 올리는 법까지 정리했다.
Q. 텐센트 Hy4 Flash, 가중치가 공개됐다는데 내 서버에서 돌릴 만한 모델인가? 가중치는 11월 17일 Hugging Face·GitHub에 공개됐다. 전체 220B 중 토큰당 12B만 활성화하는 MoE라 API 가격이 싸고, vLLM·SGLang 공식 이미지도 바로 나와 있다. 다만 FP8으로도 수백 GB가 필요하고, 독립 검증은 아직 없다. API로 먼저 써 보고, 셀프호스팅은 FP8 + vLLM으로 접근하는 게 순서다.
⚠️ 정확도 가드레일: 이 글은 2026년 11월 19일 기준이다. 스펙·아키텍처·벤치마크·배포는 텐센트 Hunyuan의 Hugging Face 모델 카드와 GitHub 레포를 직접 확인했다. 가격은 OpenRouter 페이지를 직접 확인했고, TokenHub 가격·Hy4 preview 가격·무료 기간은 2차 보도를 인용했다. 보도의 224B는 모델 카드 기준 220B로 적었다. 토리스가 직접 실행한 측정은 아니다.
30초 요약
- 11월 16일 API로 먼저 출시됐고, 11월 17일 가중치 3종(인스트럭트·FP8·베이스)이 Hugging Face·GitHub 등에 공개됐다.
- 전체 파라미터 약 220B, 토큰당 활성화 약 12B, 컨텍스트 창 100만 토큰이다.
- OpenRouter 표시가는 입력 $0.035·출력 $0.1405(100만 토큰당), 캐시 입력 $0.0015로, Hy4 preview보다 출력이 약 18배 싸다.
- 텐센트 내부 평가 WorkIndex에서 42.1점으로 Hy4 preview(39.7점)를 앞섰고, 작업당 비용은 Hy4의 20분의 1이라고 한다. 단, 독립 검증은 아직 없다.
Hy4 Flash는 무엇이 달라졌나
Hy4 Flash는 Hy4의 경량 버전이다. MoE 구조라 전체 220B 중 토큰 하나를 처리할 때는 512개 전문가 중 16개만 켜서 약 12B만 활성화한다. "220B 모델"이라는 크기와 실제 연산량은 다르다.
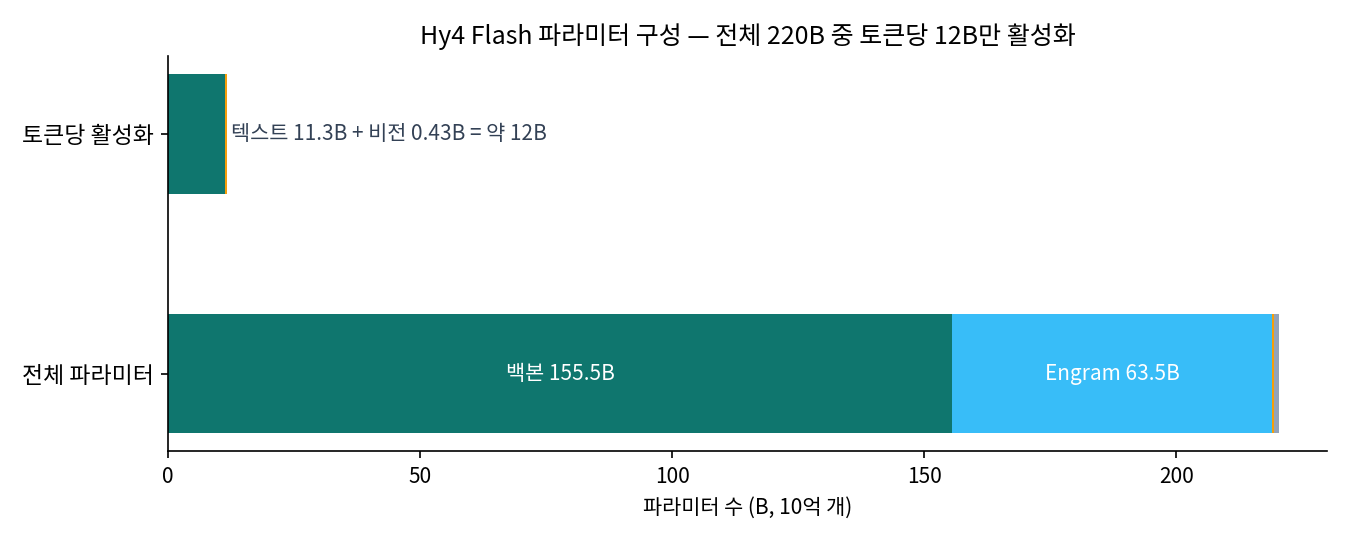
싸게 만든 비결은 세 가지다. 희소 어텐션과 슬라이딩 윈도우 어텐션을 1:3으로 섞은 하이브리드 어텐션, 전문가를 저차원 잠재 공간에서 돌리는 LatentMoE, bigram·trigram을 해시 조회로 가져오는 Engram이다. KV 캐시가 Hy4의 6분의 1로 줄었고, 디코딩 속도는 초당 150토큰을 넘는다고 모델 카드는 말한다.
텍스트·이미지 입력, 텍스트 출력이다. 42층 백본에 5층짜리 추측 디코딩 드래프터 DFly2(0.85B)가 내장돼 있다. 일상 업무·딥서치·문서·슬라이드·컴퓨터 사용이 권장 용도이고, 긴 호흡의 소프트웨어 엔지니어링에는 Hy4를 쓰라고 텐센트 스스로 적어 뒀다.
가격은 얼마나 싸나
OpenRouter 표시가는 100만 토큰당 입력 $0.035, 출력 $0.1405, 캐시 입력 $0.0015이며, 50% 할인 표시가 붙어 있다. 정가는 $0.07/$0.281 수준이다.
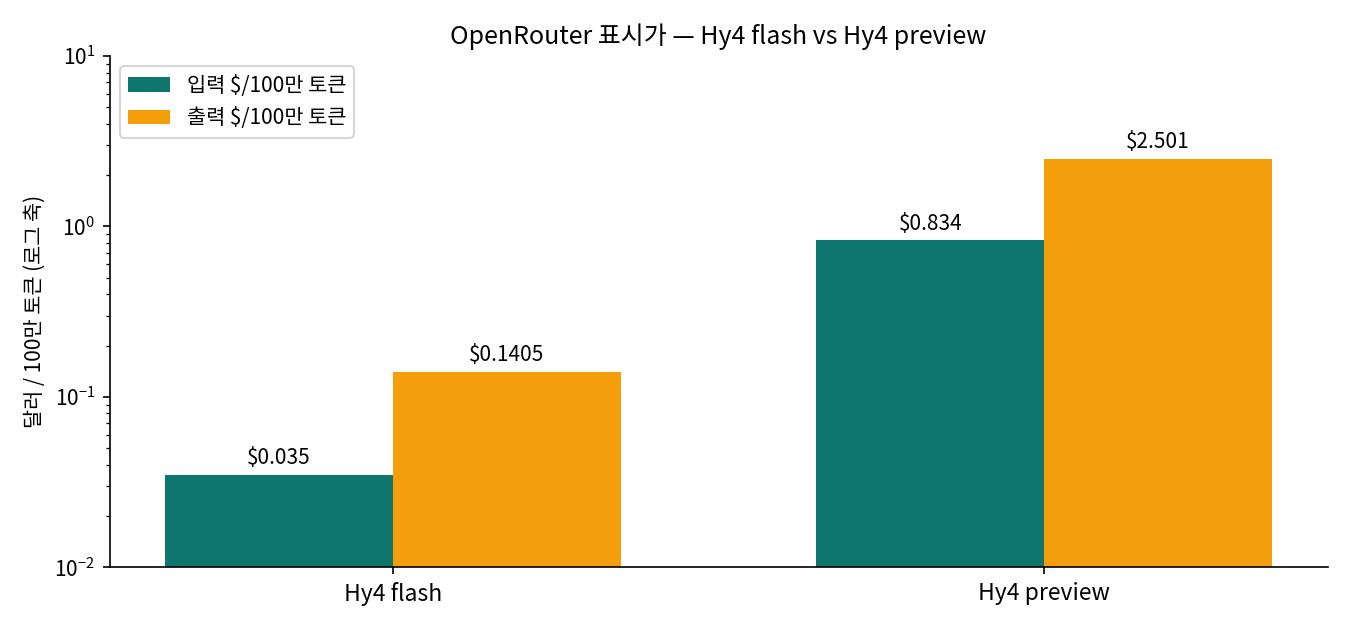
Hy4 preview보다 입력은 약 24배, 출력은 약 18배 싸다(Hy4 preview 가격은 2차 출처 인용). TokenHub 정가는 입력 0.5위안·출력 2위안이고, WorkBuddy는 11월 30일까지 무료라고 한다. "100만 토큰당 7센트"는 정가 기준이고, 지금 보이는 가격은 할인 가격이다.
Qwen4-Max와 달리, Hy4 flash는 단가보다 가중치 공개가 더 크다.
성능은 어디까지 믿을 수 있나
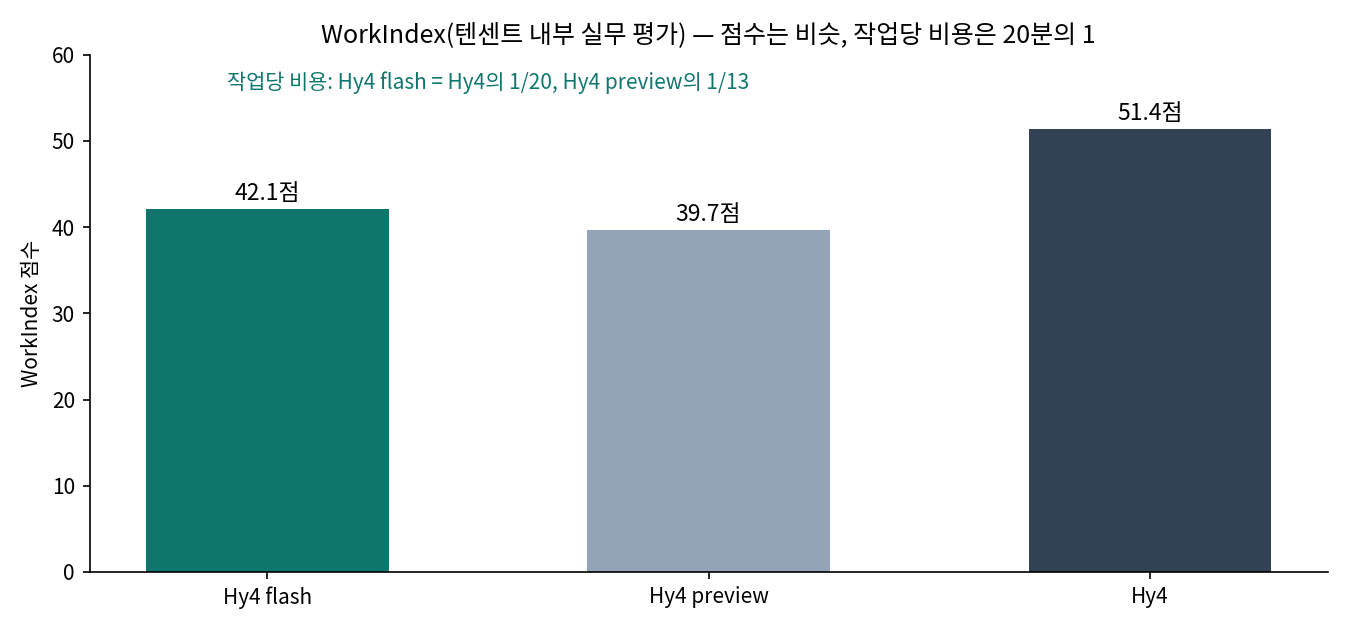
텐센트가 내세우는 숫자는 내부 실무 평가 WorkIndex다. 8개 평가 세트로 잰 점수가 Hy4 flash 42.1점, Hy4 preview 39.7점, Hy4 51.4점이다. 작업당 비용은 Hy4 preview의 13분의 1, Hy4의 20분의 1이라고 한다.
블라인드 평가(내부 사용자 85명, 259개 작업)에서는 만족도 2.79점(4점 만점)으로 Claude Haiku 5.5(2.81점)와 거의 같았고, 작업당 비용 0.26위안·완료 시간 중앙값 6.7분으로 가장 쌌고 빨랐다고 한다. Haiku 5.5의 작업당 비용 4.73위안은 2차 출처 인용이다.
다만 이 숫자는 전부 텐센트가 설계·운영한 평가다. 독립 기관의 지능 지수나 에이전트 코딩 벤치마크는 아직 없다. 베이스 모델 few-shot 점수(MMLU 88.7점, MMLU-Pro 71.1점)도 Hy4 베이스보다 낮다. 내 작업으로 직접 검증이 필요하다.
내 서버에서 돌리는 법
가중치는 tencent/Hy4-flash(인스트럭트), tencent/Hy4-flash-FP8, tencent/Hy4-flash-base(프리트레인) 세 가지다. 베이스는 채팅에 바로 쓰면 안 된다.
vLLM·SGLang 공식 이미지가 바로 나와 있다. 모델 카드 권장 vLLM 실행 명령(텐서 병렬 8개, FP8 기준)은 다음과 같다.
docker run --gpus all -p 8000:8000 --ipc=host \
  -v ~/.cache/huggingface:/root/.cache/huggingface \
  vllm/vllm-openai:hy4-flash tencent/Hy4-flash-FP8 \
    --tensor-parallel-size 8 \
    --speculative-config '{"num_speculative_tokens":5,"method":"dfly"}' \
    --attention-backend FLASHMLA_SPARSE \
    --tool-call-parser hy_v4 --reasoning-parser hy_v4 \
    --enable-auto-tool-choice --port 8000 \
    --served-model-name hy4-flash
SGLang은 lmsysorg/sglang:hy4-flash 이미지에 --speculative-algorithm DFLY를 쓴다. FP8이라도 가중치는 수백 GB대라 개인 개발자는 API가 현실적이고, 셀프호스팅은 GPU 8장급 서버가 있는 팀의 영역이다. Transformers 지원은 아직 메인 브랜치에 병합되지 않아 PR #50903 커밋에서 설치해야 한다.
라이선스와 시작 전 체크리스트
라이선스는 Tencent Hy License 1.0(Apache 2.0 기반 + 텐센트 추가 조건)이다. 대규모 모델 API 사업자는 별도 승인이 필요하다는 조건이 있다는 2차 보도도 있으니, 상용 API로 재판매할 계획이라면 라이선스 원문을 먼저 읽어야 한다.
체크리스트는 세 가지다. OpenRouter의 tencent/hy4-flash로 내 작업을 돌려보고 총비용을 잰다. 추론 모드는 reasoning_effort로 high(기본)와 no_think 중 고르고, 권장 샘플링은 temperature 0.9, top_p 1.0이다. 플래그십 Hy4의 가중치는 아직 공개되지 않았다.
토리스의 판단
토리스는 Hy4 flash를 "최고 성능 모델"이 아니라 "싸게 많이 돌리는 기본값 후보"로 본다.
- 먼저 붙일 곳: 반복 실행이 많은 자동화 파이프라인, 긴 문서·여러 파일을 오가는 에이전트 루프, 슬라이드·문서 같은 일상 업무. 출력 단가가 Hy4 preview의 18분의 1이다.
- 조심할 곳: 최고 지능이 필요한 복잡한 코딩 에이전트의 기본 모델. WorkIndex 42.1점은 Hy4(51.4점)보다 낮다.
- 셀프호스팅 판단 기준: GPU 8장급 서버가 없다면 API가 답이다. 가중치 공개의 가치는 "가격이 올라도, API가 막혀도, 내 서버로 옮길 길이 있다"는 보험에 가깝다. MAI Code 2와 Flash처럼 호스팅 전용 저가 모델과 달리, 이 보험이 Hy4 flash의 진짜 차별점이다.
출처
광고
YOUTUBE · TORIS STUDIO
토리스 영상 더 보기
동영상
-
 코딩 에이전트를 폰으로 조종까지..오늘 깃허브를 뒤집은 오픈소스 TOP 10 (11.18 트렌딩)
-
 코딩 에이전트를 여러 개 돌리는 법까지..오늘 깃허브를 뒤집은 오픈소스 TOP 10 (11.17 트렌딩)
-
 에이전트를 앱 화면에 꽂는 법까지..오늘 깃허브를 뒤집은 오픈소스 TOP 10 (11.16 트렌딩)
-
 에이전트 토큰 확 줄이는 법까지..오늘 깃허브를 뒤집은 오픈소스 TOP 10 (11.15 트렌딩)
-
 AI 에이전트에 '스킬'을 입혀라..오늘 깃허브를 뒤집은 오픈소스 TOP 10 (11.14 트렌딩)
-
 알리바바가 사내 AI 코드 리뷰어를 풀었다..오늘 깃허브를 뒤집은 오픈소스 TOP 8 (11.13 트렌딩)
-
 클로드 페이블 5.2, 점수만 보고 쓰면 비용이 터집니다 | 에포트 High vs Max 공식 가이드
-
 오늘 깃허브를 뒤집은 오픈소스 TOP 9 (11.12) | 메타 Astryx·구글·오픈AI 깃허브 트렌딩 총정리
쇼츠
-
 구글 말고 사람들 진짜 반응 검색? 깃허브 트렌딩 2위 오픈소스 last30days 🔎
-
 프롬프트 한 줄로 3D 게임 완성? AI 앱 홀리몰리 🎮
-
 헤이젠 아바타 6, 84%가 진짜 사람이랑 구별 못 했대요 🤯
-
 구글 제미나이 태스크, 한국에서도 드디어 무료로 풀렸어요 🔥
-
 오픈AI가 GPT-6.2를 둘로 나눴어요. 아스트라와 솔, 뭐가 다를까? 🔥
-
 코딩 에이전트 여러 개를 동시에? 깃허브 트렌딩 2위 오픈소스 Orca 🐋
-
 노트북LM이 웹사이트를 만들어준다고? 제미나이 노트북 'make me a site' 🔥
-
 맥 용량 범인은 AI 모델? 로컬 모델·캐시까지 싹 정리하는 오픈소스 MangoDisk 💾