Qwen4-Max, 가격은 25% 내렸는데 지능은 43점
알리바바 Qwen4-Max가 11월 16일 정식 출시됐다. 싱가포르 기준 입력 $1.50·출력 $4.50으로 전 세대보다 25% 싸졌고, 작업당 비용은 3분의 1 수준으로 줄었다. 다만 독립 지능 지수는 43점으로 Opus 5.5보다 16점 낮다.
Q. Qwen4-Max, 전 세대보다 싸졌다는데 실무에 써도 될까? 가격은 확실히 내렸다. 싱가포르 기준 100만 토큰당 입력 $1.50·출력 $4.50으로 전 세대보다 25% 싸고, 작업당 비용은 벤더 측정과 독립 측정 모두 3분의 1 수준으로 줄었다. 다만 독립 지능 지수는 43점으로 Opus 5.5(59점)보다 16점 낮고, 작업당 시간도 느리다. 긴 작업을 싸게 돌리는 용도라면 후보고, 최고 성능이 필요한 작업의 기본 모델로는 아직 이르다.
⚠️ 정확도 가드레일: 이 글은 2026년 11월 19일 기준이다. 출시·스펙·벤더 벤치마크는 Qwen 공식 블로그(2026년 11월 16일), 가격·한도는 Alibaba Cloud Model Studio 요금표와 QwenCloud 모델 페이지를 직접 열어 확인했다. 독립 점수 43점과 속도 수치는 Artificial Analysis 모델 페이지에서 직접 확인했고, 경쟁 모델 점수·작업당 비용($3.27)·순위·DeepSWE 수치는 2차 보도를 인용했다. 토리스가 직접 실행해 측정한 결과는 아니며, 한국 전용 요금은 없고 모두 USD 기준이다.
30초 요약
- 알리바바는 2026년 11월 16일 Qwen4 계열의 첫 모델 Qwen4-Max를 정식 출시했다. 모델 ID는
qwen4-max이며, 11월 11일 Token Plan 전용 프리뷰에서 5일 만에 정식 출시로 넘어왔다. - 싱가포르 API 가격은 100만 토큰당 입력 $1.50·출력 $4.50, 캐시 입력 $0.075로 전 세대보다 25% 싸다.
- 벤더 자체 평가(Work360)에서는 52.69점으로 전 세대(47.74점)를 앞섰고, 작업당 평균 비용이 $4.43에서 $1.67로 62% 줄었다.
- 독립 평가(Artificial Analysis)는 지능 지수 43점으로 Opus 5.5(59점)보다 16점 낮게 매겼고, 작업당 31.3분으로 속도도 느리다.
Qwen4-Max는 무엇이 달라졌나
Qwen4-Max는 Qwen 계열 4세대 첫 모델이다. GDN(Gated DeltaNet)과 Qwen Sparse Attention으로 긴 문맥의 주의 비용을 줄이고, Gated Residual로 학습 안정성을 높이며, N-gram 임베딩으로 지역 토큰 패턴을 더 잘 잡는다는 설명이다.
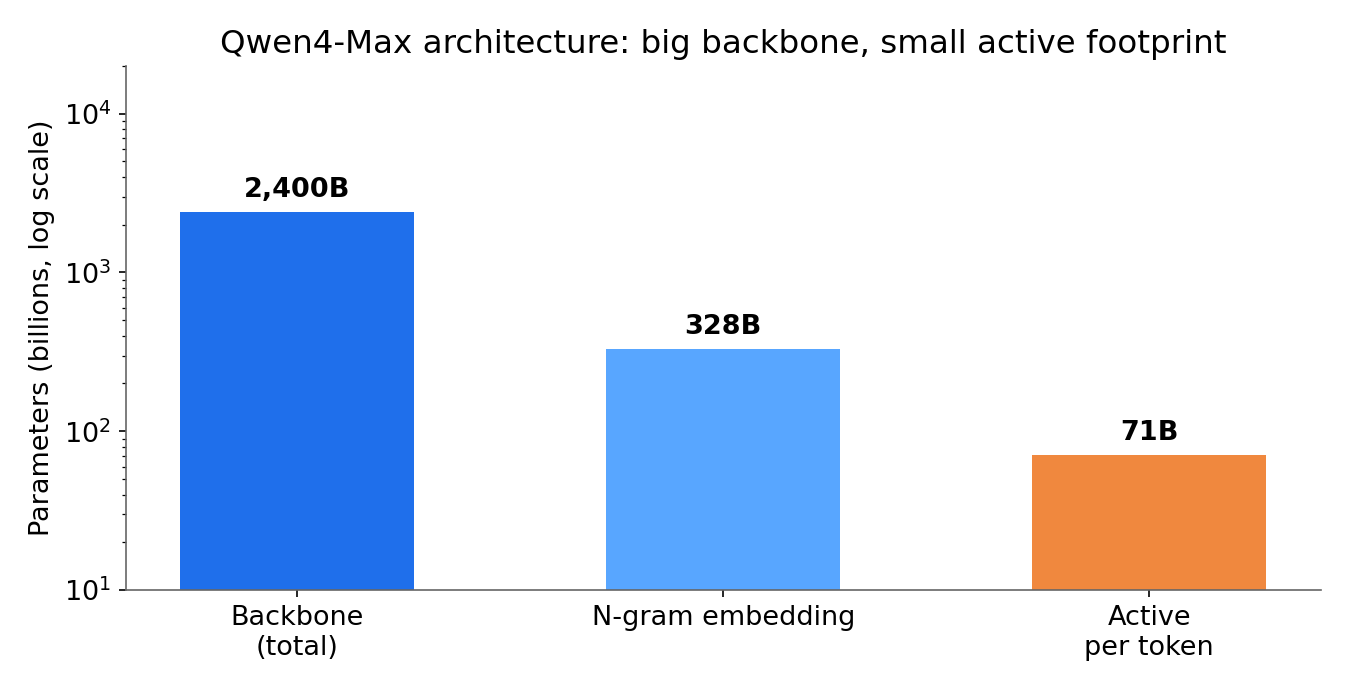
백본 2.4조 파라미터는 모델 전체 크기이고, 토큰 하나를 처리할 때 실제로 켜지는 파라미터는 71B이다. "2.4조"가 곧 연산량이라는 뜻이 아니다.
컨텍스트 창은 100만 토큰이다. 최대 입력 991K·최대 출력 131K, 생각 모드를 켜면 출력 262K까지 쓸 수 있다. 텍스트·이미지·비디오 입력과 웹 검색·도구 호출·구조화 출력을 지원하고, OpenAI·Anthropic API와 호환된다.
알리바바 공개 데모는 48시간 동안 스스로 냉각제 분자를 설계·합성·검증한 에이전트 실행, 자동차 부품 가공을 475분에서 24분으로 줄인 사례 등이다. 독립 검증은 없다.
가격은 전 세대보다 25% 싸졌다
가격은 Alibaba Cloud Model Studio 요금표에서 직접 확인했다. 싱가포르(International) 기준 100만 토큰당 입력 $1.50, 출력 $4.50이다. 생각 모드 여부와 관계없이 요금이 같고, 출력가에는 생각 토큰과 답변이 함께 들어간다.
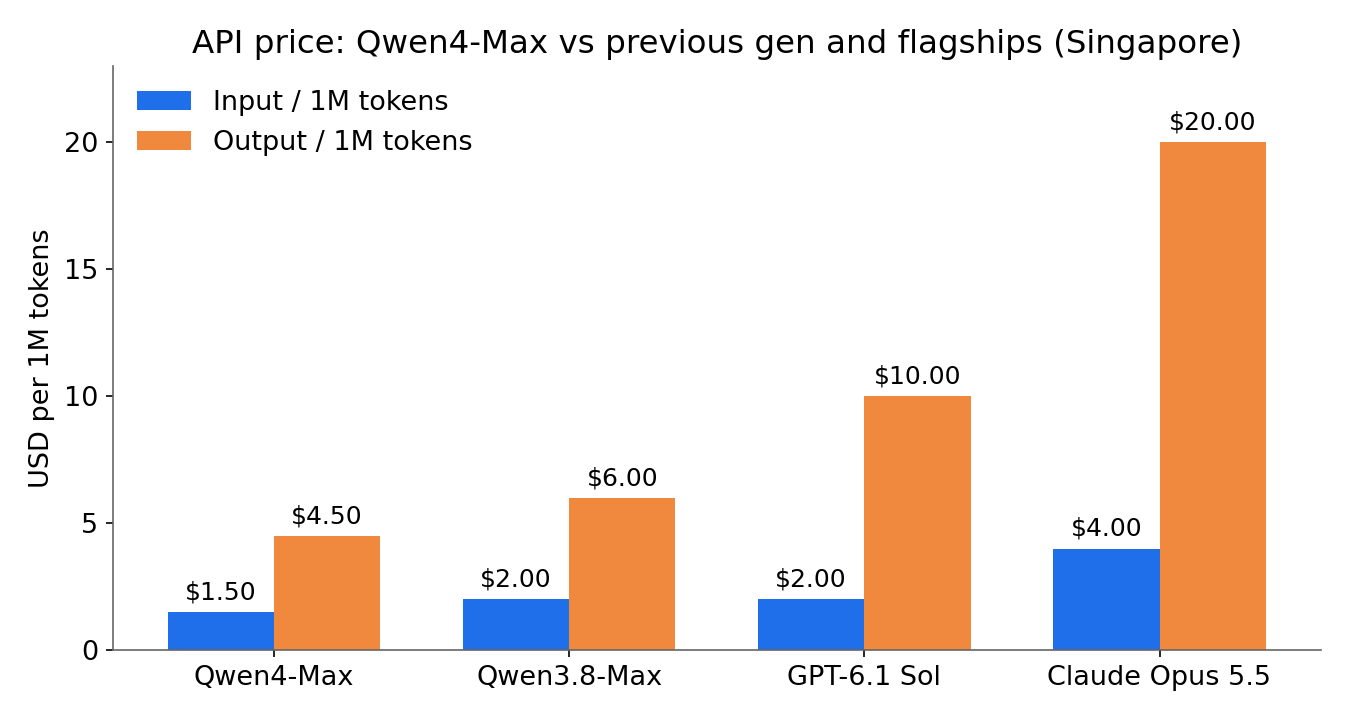
캐시 읽기는 $0.075로 입력가의 95% 할인이고, 캐시 생성은 5분 유지 $1.875, 1시간 유지 $3이다. 싱가포르 신규 계정에는 100만 토큰 무료 쿼터가 90일 유효로 붙는다.
전 세대 Qwen3.8-Max는 싱가포르 기준 입력 $2·출력 $6이었으니, Qwen4-Max는 입력·출력 모두 정확히 25% 싸졌다. MAI Code 2와 Flash(입력 $1·출력 $5)와 비교하면 입력은 비싸고 출력은 싸다. 토큰 단가만 보고 고르면 틀린다. 출력 토큰 길이가 작업당 청구액을 가른다.
두 개의 벤치마크 숫자, 왜 엇갈리나
이 모델의 평가는 벤더 숫자와 독립 숫자가 정반대 방향을 가리킨다. 측정한 것이 다르기 때문이다.
먼저 벤더 숫자다. 알리바바의 자체 실무 평가 Work360(721개 전문 분야의 산업 태스크)에서 Qwen4-Max는 52.69점으로 전 세대 47.74점을 앞섰다. 토큰 사용량은 24~35% 줄었고, 작업당 평균 비용은 $4.43에서 $1.67로 62% 줄었다고 알리바바는 말한다. 단, 알리바바가 직접 설계·운영하는 평가라 독립 재현이 없다.
벤더가 공개한 비교 차트에는 코딩 에이전트 평가 DeepSWE v1.1에서 Qwen4-Max 75.7, Claude Opus 5.5 74.2로 표시돼 있다. 알리바바가 고른 차트이며 2차 보도를 통한 인용이다.
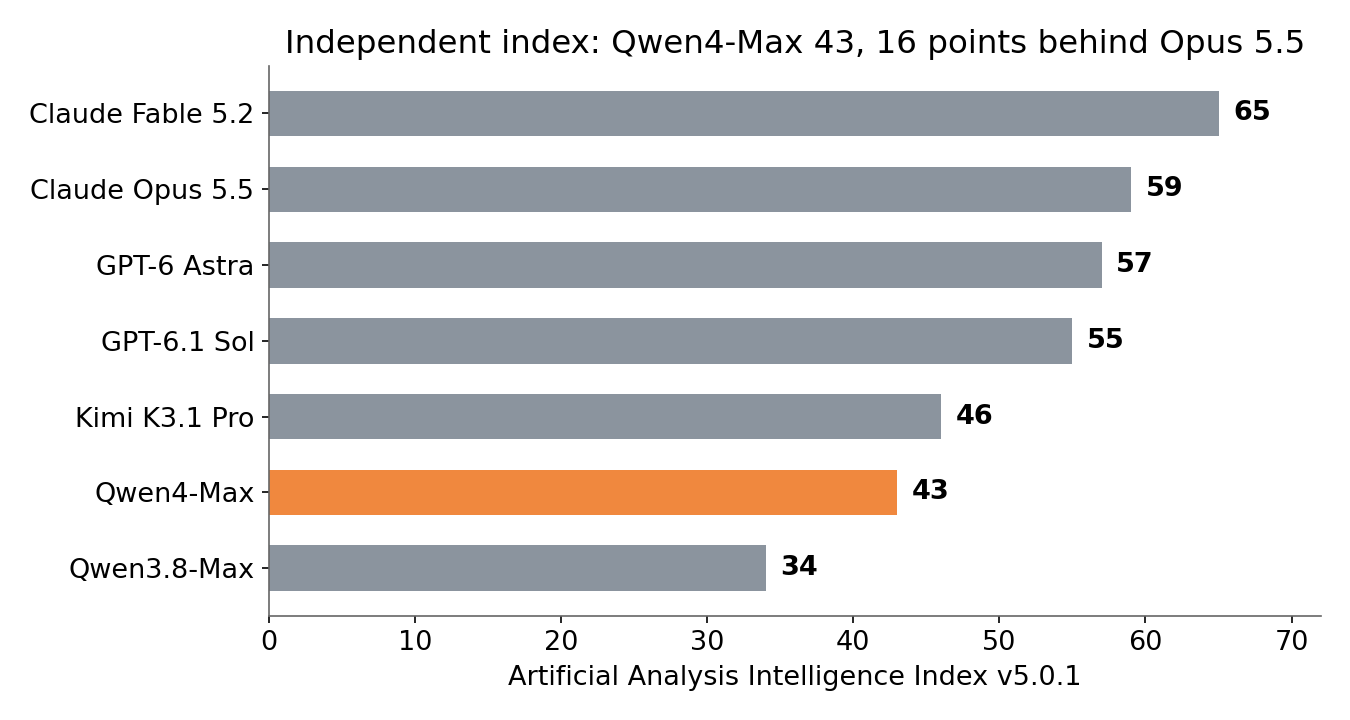
독립 평가는 다르게 말한다. Artificial Analysis의 Intelligence Index v5.0.1(9개 평가 종합)에서 Qwen4-Max는 43점이다. 전 세대 34점보다 9점 올랐지만, Kimi K3.1 Pro 46점, GPT-6.1 Sol 55점, GPT-6 Astra 57점, Claude Opus 5.5 59점, Claude Fable 5.2 65점에는 못 미친다.
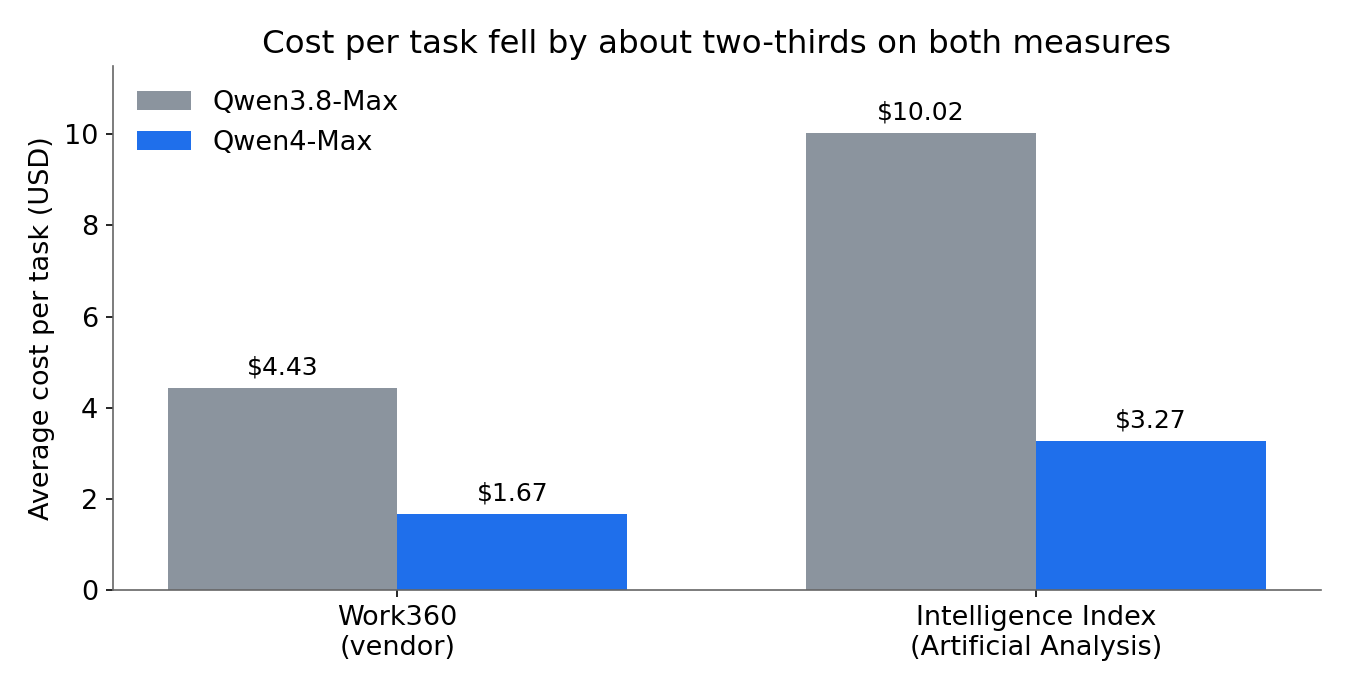
흥미로운 대목은 비용이다. 독립 측정에서도 작업당 비용은 $10.02에서 $3.27로 3분의 1 수준으로 줄었다. Kimi K3.1 Pro의 $3.68보다도 싸다. 다만 속도가 발목을 잡는다. 작업당 31.3분으로 같은 가격대 중앙값 12.3분의 두 배가 넘고, 첫 답변 토큰까지 146.14초(중앙값 13.10초)가 걸린다. 독립 평가는 최고 추론 설정(xhigh) 기준이고, API 기본 설정은 high라 실제 체감은 달라질 수 있다.
벤더 숫자는 "전 세대보다 싸고 효율적이다"를, 독립 숫자는 "최상위권과는 아직 거리가 있고 느리다"를 말한다.
어디서 쓰고, 무엇이 안 되나
Qwen4-Max는 QwenCloud API(종량제)와 Token Plan, QwenWork·Qoder·QwenStudio에서 쓸 수 있다. 모델 ID는 qwen4-max, 분당 토큰 한도(TPM)는 500만이다.
주의할 날짜가 하나 있다. 프리뷰 식별자 qwen4-max-preview와 qwen4.0-max-preview는 2026년 11월 25일 24:00(UTC+8)에 종료된다. 프리뷰로 붙여둔 코드는 그전에 정식 ID로 바꿔야 한다.
안 되는 것도 분명하다. 가중치는 공개되지 않은 호스팅 전용 모델이라 내 서버에서 직접 돌릴 수 없다. Model Studio 문서 정리 기준으로는 파인튜닝과 모델 배포도 미지원으로 표기돼 있다.
토리스의 판단
토리스는 Qwen4-Max를 "최고 성능 모델"이 아니라 "긴 작업을 싸게 돌리는 기본값 후보"로 본다.
- 먼저 붙일 곳: 긴 문서·여러 파일을 오가는 에이전트 루프, 반복 실행이 많은 자동화 파이프라인. 단가 인하와 토큰 사용량 감소가 겹쳐 작업당 비용이 크게 준다. 싱가포르 무료 쿼터 100만 토큰으로 먼저 시험해 볼 수 있다.
- 조심할 곳: 최고 지능이 필요한 추론·복잡한 코딩 에이전트의 기본 모델. 독립 지수 43점, 작업당 31.3분, 첫 토큰 146초는 "싸지만 느리고 말이 많다"는 뜻이다.
- 갈아타기 전 할 일: 프리뷰 ID를 쓰고 있다면 11월 25일 전에
qwen4-max로 교체한다. 실제 저장소 작업 하나를 골라 Qwen4-Max와 지금 쓰는 모델로 같은 프롬프트를 돌리고 총 토큰·소요 시간·diff 품질을 기록한다.
토리스가 모델을 고를 때 보는 기준은 진행 방식과 개발 서비스에도 정리돼 있다.
출처
- Qwen4-Max: Your New Teammate Has Arrived - Qwen Team
- Qwen4-Max - QwenCloud
- Alibaba Cloud Model Studio Model Prices
- Qwen4 Max - Artificial Analysis
- Alibaba's new flagship AI model is cheap to use but trails US leaders on an independent test - machine.net
- Qwen4-Max Is Live: Alibaba's Flagship Is 25% Cheaper - Help Me Boss
광고
YOUTUBE · TORIS STUDIO
토리스 영상 더 보기
동영상
-
 코딩 에이전트를 폰으로 조종까지..오늘 깃허브를 뒤집은 오픈소스 TOP 10 (11.18 트렌딩)
-
 코딩 에이전트를 여러 개 돌리는 법까지..오늘 깃허브를 뒤집은 오픈소스 TOP 10 (11.17 트렌딩)
-
 에이전트를 앱 화면에 꽂는 법까지..오늘 깃허브를 뒤집은 오픈소스 TOP 10 (11.16 트렌딩)
-
 에이전트 토큰 확 줄이는 법까지..오늘 깃허브를 뒤집은 오픈소스 TOP 10 (11.15 트렌딩)
-
 AI 에이전트에 '스킬'을 입혀라..오늘 깃허브를 뒤집은 오픈소스 TOP 10 (11.14 트렌딩)
-
 알리바바가 사내 AI 코드 리뷰어를 풀었다..오늘 깃허브를 뒤집은 오픈소스 TOP 8 (11.13 트렌딩)
-
 클로드 페이블 5.2, 점수만 보고 쓰면 비용이 터집니다 | 에포트 High vs Max 공식 가이드
-
 오늘 깃허브를 뒤집은 오픈소스 TOP 9 (11.12) | 메타 Astryx·구글·오픈AI 깃허브 트렌딩 총정리
쇼츠
-
 구글 말고 사람들 진짜 반응 검색? 깃허브 트렌딩 2위 오픈소스 last30days 🔎
-
 프롬프트 한 줄로 3D 게임 완성? AI 앱 홀리몰리 🎮
-
 헤이젠 아바타 6, 84%가 진짜 사람이랑 구별 못 했대요 🤯
-
 구글 제미나이 태스크, 한국에서도 드디어 무료로 풀렸어요 🔥
-
 오픈AI가 GPT-6.2를 둘로 나눴어요. 아스트라와 솔, 뭐가 다를까? 🔥
-
 코딩 에이전트 여러 개를 동시에? 깃허브 트렌딩 2위 오픈소스 Orca 🐋
-
 노트북LM이 웹사이트를 만들어준다고? 제미나이 노트북 'make me a site' 🔥
-
 맥 용량 범인은 AI 모델? 로컬 모델·캐시까지 싹 정리하는 오픈소스 MangoDisk 💾