Inkling 2 Mini, 노트북에서 도는 26B 루프 모델 정리
Thinking Machines Lab이 11월 20일 공개한 Inkling 2 Mini는 24개 레이어 중 12개를 세 번 돌리는 루프 트랜스포머다. 20GB로 노트북에서 돌면서 코딩 벤치마크에서 Qwen3.8-27B를 앞섰다.
Q. 노트북에서 돌아가는 작은 오픈 모델이 코딩 에이전트에서 Qwen3.8-27B를 이길 수 있나요? 네, 조건부로 가능합니다. Thinking Machines Lab이 11월 20일 공개한 Inkling 2 Mini는 24개 레이어 중 가운데 12개를 토큰마다 세 번 돌리는 '루프 트랜스포머'로, 약 20GB로 노트북에서 돌면서 DeepSWE v1.1 48.2%, SWE-bench Pro v2 Hard 77.9%를 기록했다. 다만 지식·멀티턴 지시에서는 Qwen3.8-27B에 뒤지므로, 코딩 에이전트용 로컬 모델로 쓸 때가 가장 맞다.
⚠️ 정확도 가드레일: 이 글은 2026년 11월 21일 기준이다. 수치는 Thinking Machines Lab 공식 발표와 Artificial Analysis 평가(둘 다 11월 20일)를 직접 열어 확인했다. 벤치마크는 발표사 자체 측정이라 조건이 모델마다 다를 수 있고, 토리스가 직접 실행한 결과는 아니다. 모델 카드의 사용 정책 적용 여부는 직접 확인하지 못했으니 상용 전 모델 카드를 확인할 것.
30초 요약
- Inkling 2 Mini는 11월 20일 공개된 Apache 2.0 오픈웨이트 모델이다. 총 26.4B 중 토큰당 3.4B만 활성화하고, 중간 레이어를 세 번 돌려 토큰당 5.4B 가중치 활성화를 만든다.
- 코딩 에이전트 벤치마크에서 동급 최강이다. DeepSWE v1.1 48.2%, SWE-bench Pro v2 Hard 77.9%, SWE-bench Verified 79.2%로 Qwen3.8-27B를 앞섰고, 지능 지수 20.1로 동점이다.
- Artificial Analysis 기준 작업당 0.59달러·9.0분으로, 3.53달러·38.2분인 Qwen3.8-27B보다 약 6배 싸고 4배 빠르다.
- 메모리 풋프린트 약 20GB로 노트북에서 돌고, vLLM은 출시 당일 지원을 냈다. 텍스트·이미지 입력, 100만 토큰 컨텍스트를 지원한다.
- 약점은 지식·멀티턴 지시다. MultiChallenge 50.0%, ComplexConstraints 33.4%로 Qwen3.8-27B에 뒤지고, 루프가 늘수록 추론을 글로 적지 않고 안에서 처리하는 비중이 커진다.
루프 트랜스포머란 — 24개 레이어를 세 번 돌린다
Inkling 2 Mini의 핵심은 파라미터를 늘리는 대신 같은 레이어를 반복해 쓰는 설계다.
24개 디코더 레이어를 네 블록으로 나눈다. 앞 6개와 뒤 6개는 한 번씩만 돌고, 가운데 12개는 가중치를 공유한 채 세 번 돈다. 저장된 레이어는 24개지만 토큰 하나가 거치는 레이어 적용 횟수는 6 + (12 × 3) + 6 = 48회다.
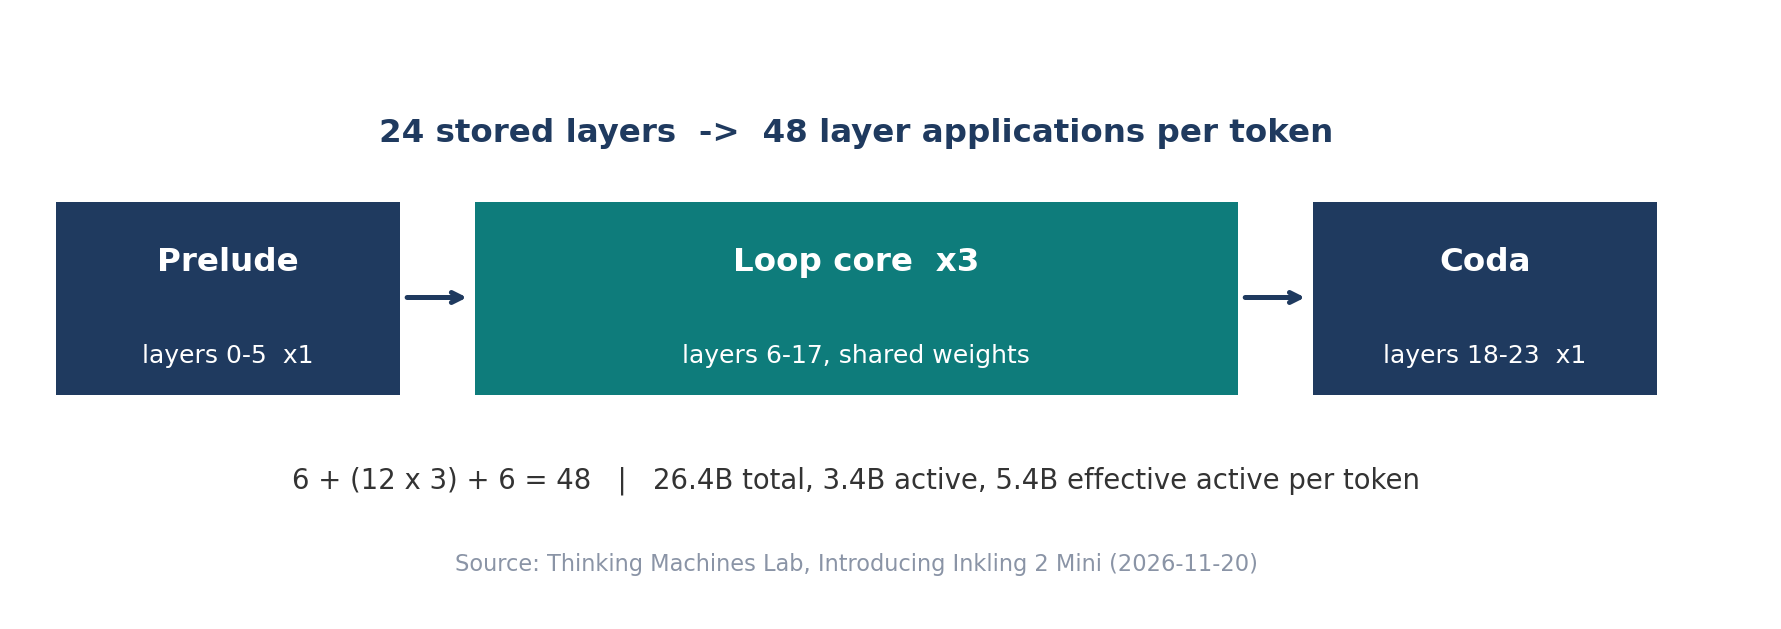
파라미터 숫자는 세 가지로 구분해야 한다. 총합 26.4B, 토큰당 활성 3.4B, 루프 반복까지 합친 토큰당 가중치 활성화 5.4B다. 양자화도 훈련 단계부터 설계됐다. 전문가 레이어 20개는 NVFP4 4비트, 마지막 4개는 MXFP8 8비트로 훈련했고 배포 시에도 같은 정밀도를 그대로 쓴다.
코딩 벤치마크 — Qwen3.8-27B를 앞선 지점과 진 지점
에이전트 코딩에서는 동급 오픈웨이트 중 가장 강하고, 지식·멀티턴 지시에서는 Qwen3.8-27B에 뒤진다.
발표사 벤치마크 표에서 Inkling 2 Mini는 DeepSWE v1.1 48.2%(Qwen3.8-27B 42.2%), SWE-bench Pro v2 Hard 77.9%(73.8%), SWE-bench Verified 79.2%(77.8%), Vibe Code Bench v1.1 77.9%(64.9%)를 기록했다. Terminal-Bench v2.1에서는 71.6%로 Qwen3.8-27B 73.0%에 근소하게 뒤졌다.
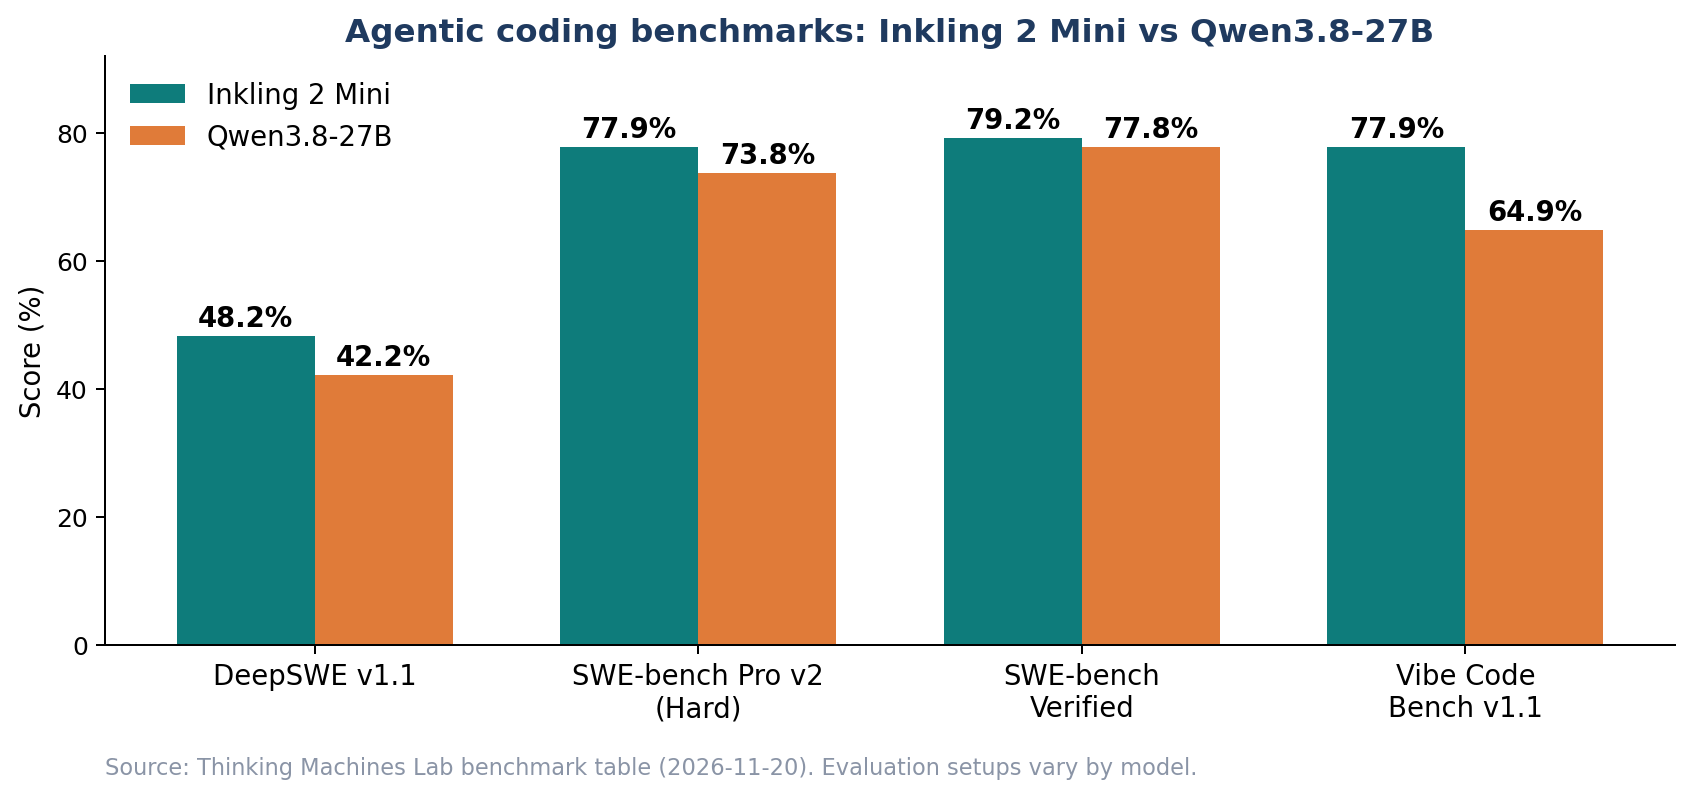
약점은 발표사가 직접 밝힌 한계에 적혀 있다. 멀티턴 챌린지 50.0%, 복잡한 제약 지시 33.4%로 Qwen3.8-27B에 뒤지고, 사실성 지표 AA-Omniscience도 -8.6으로 Qwen3.8-27B(-6.4)보다 낮다. 루프는 추론을 깊게 만들 뿐 저장된 지식 자체를 늘리지는 않는다. 대신 검색·도구 사용이 들어간 BrowseComp 79.0%, DeepSearchQA 85.3%, MCP Atlas 82.7%에서는 동급 1위다.
가격과 속도 — 6배 싸고 4배 빠르다는 말의 근거
Artificial Analysis 기준 작업당 0.59달러·9.0분으로, Qwen3.8-27B의 3.53달러·38.2분과 비교된다.
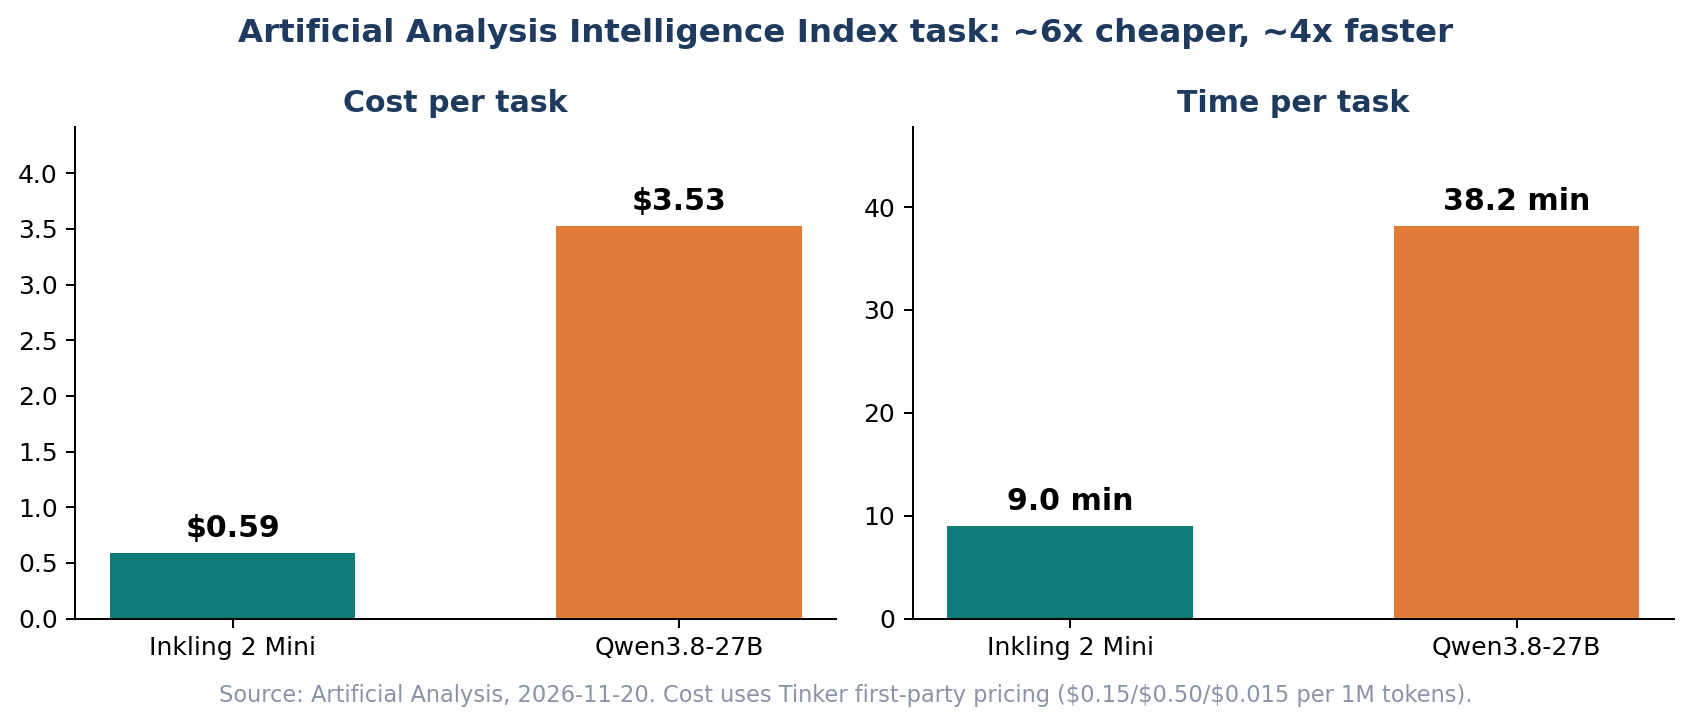
이 수치는 Thinking Machines의 자체 API 서비스 Tinker 요금(입력 100만 토큰당 0.15달러, 출력 0.50달러, 캐시 히트 0.015달러)을 기준으로 계산한 것이다. 같은 지능 지수 점수를 내는 데 출력 토큰은 Qwen3.8-27B보다 약 38% 더 쓰지만, 활성 파라미터가 작아 연산량 기준으로는 약 2.8배 덜 든다.
노트북에서 돌리는 법 — 20GB, vLLM 당일 지원
체크포인트 약 20GB라 소비자 노트북·데스크톱 AI 컴퓨터가 대상이고, 서버용 프레임워크 지원은 출시 당일부터 나왔다.
발표사는 M5 Pro 48GB 맥북 프로에서 오프라인으로 비행 시뮬레이터를 만드는 데모를 공개했다. 20GB 풋프린트라 32GB 메모리 머신이 사실상 하한선으로 보이지만, 이는 토리스의 판단이다.
실행 경로는 세 갈래다. 첫째, Tinker API다. 발표사 자체 서비스에서 추론과 커스터마이징을 제공하고 위 요금으로 과금된다. 둘째, 셀프 호스팅이다. vLLM은 출시 당일 지원을 냈고, 당분간 나이틀리 빌드나 전용 도커 이미지(vllm/vllm-openai:inkling-2-mini)를 써야 한다. 셋째, GGUF다. 커뮤니티 빌드가 나왔지만 llama.cpp 공식 지원은 아직 초안 PR 단계라 vLLM·SGLang 쪽이 낫다. 컨텍스트는 최대 100만 토큰, 입력은 텍스트·이미지, 출력은 텍스트다. 비슷한 크기에서 로컬로 돌리는 오픈웨이트를 찾는다면 Olala mini 7A1B 정리도 참고할 만하다.
루프가 가져오는 새로운 문제 — 추론을 안 적고 안에서 처리한다
루프 모델의 진짜 논점은 속도가 아니라 '모델이 생각을 글로 적지 않고 안에서 끝내는 비중이 커진다'는 점이다.
일반 트랜스포머는 토큰을 만들 때마다 고정된 레이어를 한 번씩만 거치므로, 긴 추론은 반드시 생성된 텍스트(CoT)에 적혀야 한다. 그래서 CoT를 읽는 것이 모델을 감시하는 도구가 된다. 루프 모델은 토큰을 내기 전에 안에서 더 많은 계산을 하므로, 글로 적히지 않는 추론이 늘어날 수 있다.
발표사는 연구용 가변 루프 모델(TML-d24-varloop-research)까지 함께 공개해 측정했다. CoT 없이 푸는 작업의 시간 지평은 1회 패스 16초에서 3회 패스 37초로 늘었고, CoT 길이는 5회 패스에서 1회 패스의 절반 이하(평균 1,661 토큰 대 3,703 토큰)로 줄었지만 가독성은 유지됐다. CoT를 의도대로 조종하는 능력은 0.1% 이하로 비교 모델들보다 낮았다. 발표사의 결론은 "이 규모에서는 루프가 모니터링을 의미 있게 해치지 않는다"는 것이지만, 3회 패스 기준 강화학습 모델에서의 예비 분석이다.
실무적으로는 이렇게 정리된다. 로컬 코딩 에이전트처럼 모델이 직접 코드를 고치고 테스트를 돌리는 작업에는 루프의 이득이 크다. 반면 판단 근거를 글로 남겨야 하는 감사·규제 환경에서는 CoT가 짧아지는 특성을 인지하고 로그·도구 호출 기록을 함께 남기는 설계가 필요하다.
토리스의 판단
토리스는 Inkling 2 Mini를 "작은 모델의 한계를 구조로 깬 사례"로 본다. 파라미터를 늘리지 않고 같은 레이어를 세 번 돌려 코딩 에이전트 성능을 동급 1위로 끌어올렸고, 비용·속도·로컬 실행 가능성까지 한 번에 맞췄다.
다만 용도를 가려야 한다. 로컬 코딩 에이전트와 검색·도구를 쓰는 리서치 에이전트에는 강하고, 멀티턴 대화와 암기 지식에 의존하는 질의응답에는 Qwen3.8-27B가 여전히 낫다. 발표사 수치가 자체 측정이라는 점도 감안해, 내 작업 샘플을 직접 돌려보고 갈아타는 편이 안전하다. 써볼 순서는 Tinker API로 샘플을 돌려보고, 맞으면 vLLM으로 로컬에 올리는 것이다. 상용 전에는 모델 카드의 사용 정책을 직접 확인하고, 에이전트 로그는 도구 호출 기록까지 함께 남겨야 한다.
출처
광고
YOUTUBE · TORIS STUDIO
토리스 영상 더 보기
동영상
-
 코딩 에이전트를 폰으로 조종까지..오늘 깃허브를 뒤집은 오픈소스 TOP 10 (11.18 트렌딩)
-
 코딩 에이전트를 여러 개 돌리는 법까지..오늘 깃허브를 뒤집은 오픈소스 TOP 10 (11.17 트렌딩)
-
 에이전트를 앱 화면에 꽂는 법까지..오늘 깃허브를 뒤집은 오픈소스 TOP 10 (11.16 트렌딩)
-
 에이전트 토큰 확 줄이는 법까지..오늘 깃허브를 뒤집은 오픈소스 TOP 10 (11.15 트렌딩)
-
 AI 에이전트에 '스킬'을 입혀라..오늘 깃허브를 뒤집은 오픈소스 TOP 10 (11.14 트렌딩)
-
 알리바바가 사내 AI 코드 리뷰어를 풀었다..오늘 깃허브를 뒤집은 오픈소스 TOP 8 (11.13 트렌딩)
-
 클로드 페이블 5.2, 점수만 보고 쓰면 비용이 터집니다 | 에포트 High vs Max 공식 가이드
-
 오늘 깃허브를 뒤집은 오픈소스 TOP 9 (11.12) | 메타 Astryx·구글·오픈AI 깃허브 트렌딩 총정리
쇼츠
-
 구글 말고 사람들 진짜 반응 검색? 깃허브 트렌딩 2위 오픈소스 last30days 🔎
-
 프롬프트 한 줄로 3D 게임 완성? AI 앱 홀리몰리 🎮
-
 헤이젠 아바타 6, 84%가 진짜 사람이랑 구별 못 했대요 🤯
-
 구글 제미나이 태스크, 한국에서도 드디어 무료로 풀렸어요 🔥
-
 오픈AI가 GPT-6.2를 둘로 나눴어요. 아스트라와 솔, 뭐가 다를까? 🔥
-
 코딩 에이전트 여러 개를 동시에? 깃허브 트렌딩 2위 오픈소스 Orca 🐋
-
 노트북LM이 웹사이트를 만들어준다고? 제미나이 노트북 'make me a site' 🔥
-
 맥 용량 범인은 AI 모델? 로컬 모델·캐시까지 싹 정리하는 오픈소스 MangoDisk 💾