Olala mini 7A1B, 8GB GPU에서 도는 유럽 오픈웨이트
OVHcloud의 첫 LLM Olala mini 7A1B이 11월 19일 가중치 공개됐다. 전체 6.8B 중 토큰당 1B만 활성화하고 8GB GPU·CPU에서도 돈다. 스펙·벤치마크·로컬 실행법을 정리했다.
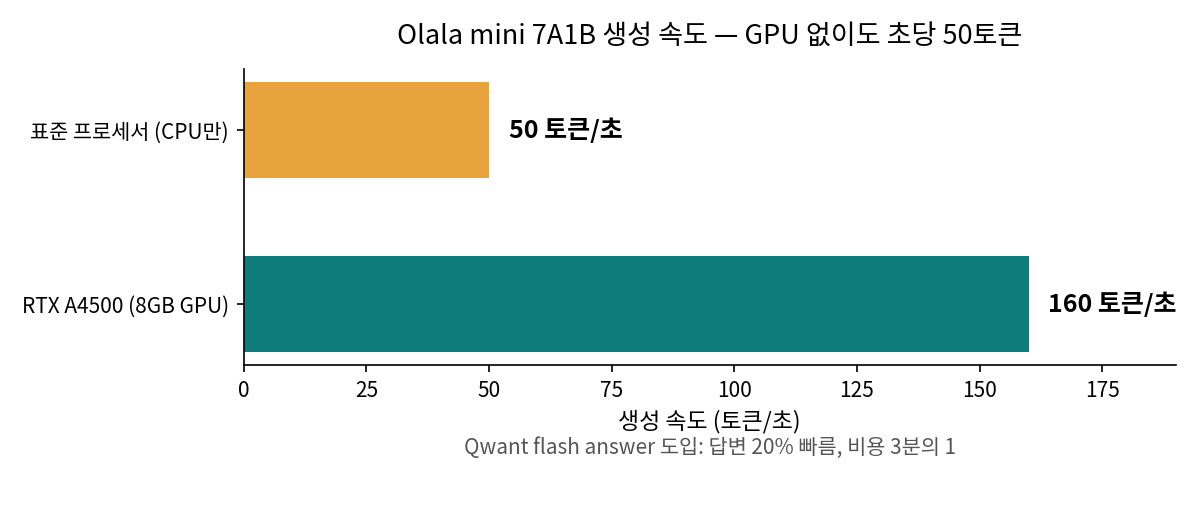
Q. OVHcloud Olala mini 7A1B, 내 노트북에서도 돌릴 수 있는 오픈웨이트 모델인가? 가중치는 11월 19일 Hugging Face에 Apache 2.0으로 공개됐다. 전체 6.8B 중 토큰당 약 1B만 활성화하는 MoE라 8GB GPU에서 초당 160토큰, CPU만으로도 초당 50토큰이 나온다고 OVHcloud는 말한다. 다만 Ollama·공식 vLLM은 아직 못 읽으니, 당장은 API로 먼저 써 보는 게 순서다.
⚠️ 정확도 가드레일: 이 글은 2026년 11월 20일 기준이다. 스펙·벤치마크·실행법은 OVHai LLM의 Hugging Face 모델 카드와 OVHcloud 보도자료(2026년 11월 17일)를 직접 열어 확인했다. 벤치마크는 OVHai LLM의 자체 평가이며, 토리스가 직접 실행해 측정한 결과는 아니다. AI Endpoints의 한국 요금과 무료 티어 여부는 공식 발표에 없어 확인하지 못했다.
30초 요약
- 11월 17일 발표, 11월 19일 AI Summit에서 공식 출시와 함께 가중치·기술 보고서·AI Act 문서가 Hugging Face에 공개됐다.
- 전체 파라미터 6.8B, 토큰당 활성 약 1B, 컨텍스트 창 32,000토큰이다. 연말 나올 v1.1은 128,000토큰으로 늘어난다.
- 12개 벤치마크 평균 68.0점으로 SFT 체크포인트보다 15.2점 높고, HumanEval+ 88.3점·Multi-IF 71.2점을 기록했다. 단, 경쟁 수학이 가장 약하다.
- 라이선스는 Apache 2.0, 한국어 포함 37개 언어로 사전학습됐다. 프랑스 검색엔진 Qwant가 이미 flash answer에 도입해 답변 20% 빠름·비용 3분의 1을 기록했다.
Olala mini는 무엇이 다른가
Olala mini 7A1B는 OVHcloud의 첫 LLM 패밀리 Olala의 첫 모델이다. 이름의 7A1B는 전체 7B 중 토큰당 활성 1B라는 뜻이고, 모델 카드 기준 전체 파라미터는 6.8B다.
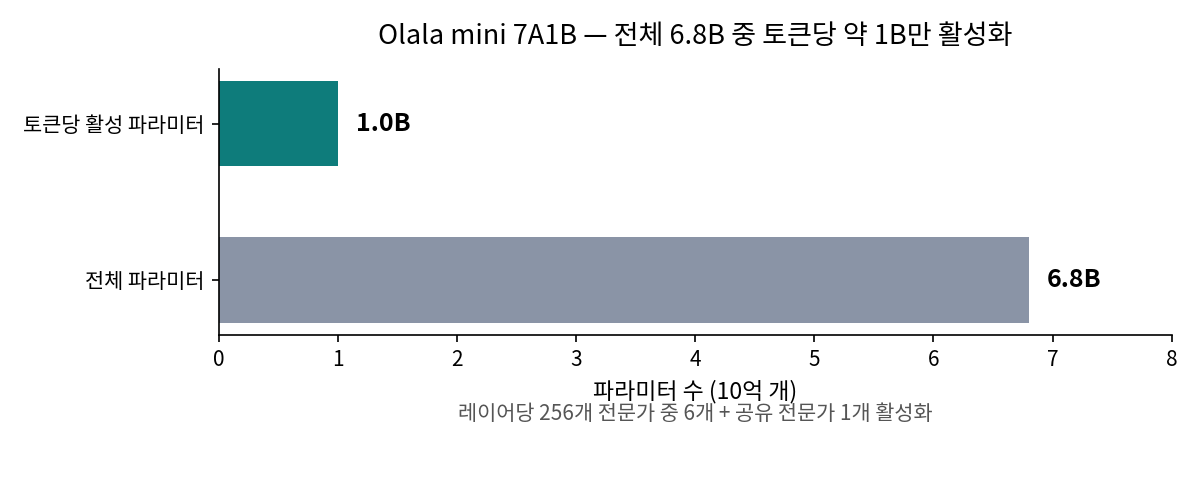
비결은 하이브리드 어텐션과 MoE의 조합이다. 36개 층 중 29개는 Mamba-3, 7개는 Differential-TPA 어텐션이라 36개 층 중 7개 층만 KV 캐시를 유지한다. 각 층 뒤에는 256개 라우팅 전문가 중 6개와 공유 전문가 1개가 붙는 MoE 블록이 있다. BF16 형식이다.
학습은 유럽 공공 슈퍼컴퓨터 세 곳에서 했다. 독일 JUPITER(GH200 1,024장)에서 프리트레인, 프랑스 Jean Zay와 룩셈부르크 MeluXina에서 파인튜닝·강화학습을 했다. 학습 데이터는 12.8T 토큰으로 공개 데이터셋과 자체 합성 데이터다.
이 모델은 추론 후 답하는 구조다. 추론 노력(reasoning effort)을 disabled·low·medium·high 네 단계로 조절하고, 기본값은 medium이다. 강화학습은 네 단계로 진행됐고, 마지막 단계에서는 도구 호출과 최대 75턴 탐색을 학습했다. 사전학습은 영어와 36개 언어, 한국어 포함이다.
성능은 어디까지 믿을 수 있나
OVHai LLM은 19개 모델을 동일 조건(inspect_ai)으로 직접 평가했다. Olala mini는 12개 벤치마크 평균 68.0점으로, SFT 체크포인트(52.8점)보다 15.2점 높다.
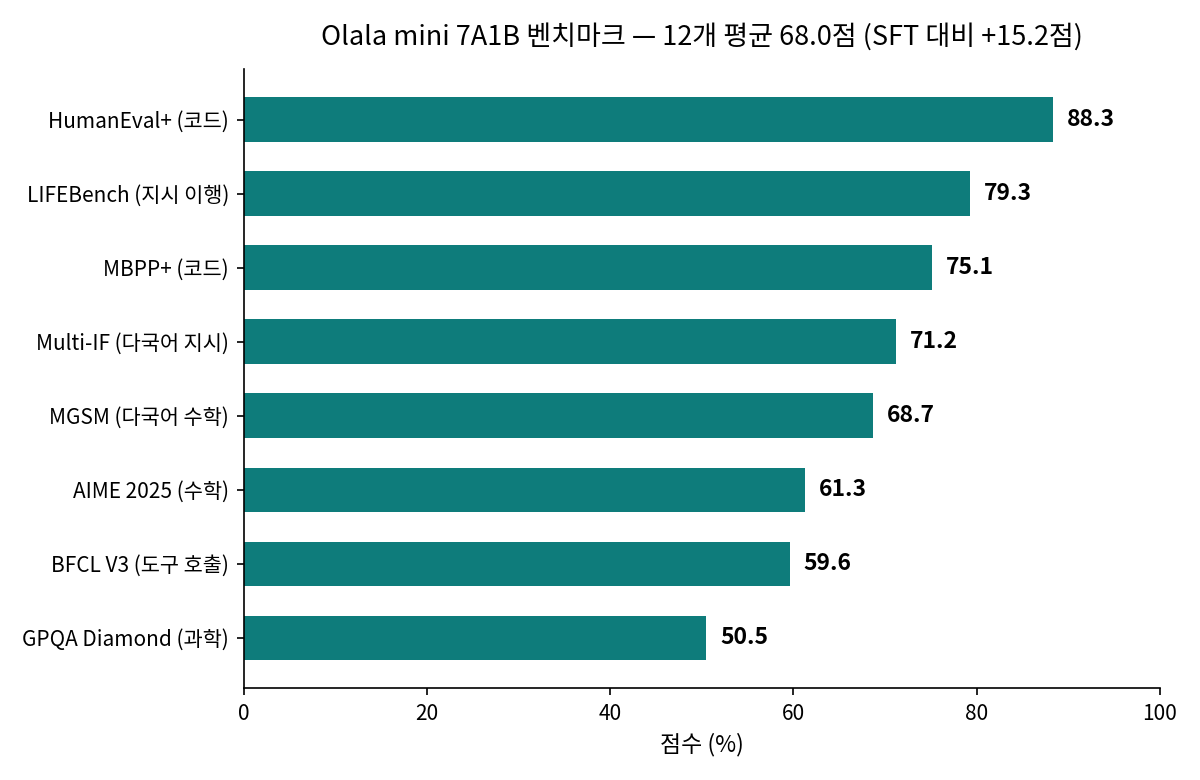
분야별 점수는 이렇다. 코드 HumanEval+ 88.3점·MBPP+ 75.1점, 지시 이행 LIFEBench 79.3점·Multi-IF 71.2점, 다국어 수학 MGSM 68.7점, 도구 호출 BFCL V3 59.6점, 과학 GPQA Diamond 50.5점이다. AIME는 2024년 60.7점·2025년 61.3점·2026년 52.7점이다.
다만 이 숫자는 전부 OVHai LLM이 설계·운영한 자체 평가다. 독립 기관의 지능 지수나 에이전트 코딩 벤치마크는 아직 없어, 내 작업으로 직접 검증이 필요하다.
안전성 평가도 함께 공개됐다. 공격 프롬프트 5,701개 기준 공격 성공률은 6.3%로 SFT(12.5%)의 절반 수준이고, 정상 요청 과다 거부는 10.7%다. 지식 컷오프는 프리트레인 2026년 1월, 포스트트레인 2026년 4월이다.
내 컴퓨터에서 돌리는 법
가장 빠른 길은 API다. OVHcloud AI Endpoints가 OpenAI 호환 API로 제공하고, Hugging Face Inference Providers와 Blade API에서도 쓸 수 있다. 베이스 URL은 https://oai.endpoints.kepler.ai.cloud.ovh.net/v1, 모델명은 Olala-v1.0-mini-7A1B다.
로컬 실행은 하드웨어별로 길이 갈린다. 맥 M2 이상·16GB라면 MLX 버전(5.4GB), GPU 없는 PC·M1 맥이라면 GGUF(6~14GB), GPU 서버(24GB 이상)라면 vLLM, 연구용이라면 Transformers(transformers==5.8.*)로 돌릴 수 있다.
주의할 점이 하나 있다. Ollama·LM Studio·공식 llama.cpp·vLLM·mlx-lm은 아직 olala 아키텍처를 읽지 못한다. 모델 카드가 안내하는 포크 버전을 써야 한다. vLLM은 OVHai LLM 포크 이미지(ovhaillm/olala-vllm)로 띄우고, --mamba-ssm-cache-dtype float32 옵션을 반드시 붙여야 한다. 기본값인 bf16 Mamba 상태로는 긴 생성이 반복 루프에 빠진다. GGUF도 포크 llama.cpp가 필요하고, 일반 양자화 레시피는 NaN이 나올 수 있으니 모델 카드가 공개한 GGUF·MLX 파일을 쓰는 게 안전하다.
파인튜닝도 Docker 이미지(ovhaillm/olala-ai-training) 하나로 LoRA 학습부터 병합까지 된다. H100 1장으로 1,000개 예시 학습에 약 7분이다.
이미 실전에서 쓰고 있다 — Qwant 사례
출시 전부터 실전 도입 사례가 있다. 프랑스 검색엔진 Qwant가 flash answer(검색 결과 상단 요약 답변)에 Olala mini를 도입했다. OVHcloud 보도자료에 따르면 기존 모델 대비 답변이 20% 빨라지고 비용은 3분의 1로 줄었다. 오픈웨이트 모델의 가치는 "싸다"가 아니라 "검증된 곳에서 이미 돌고 있다"는 데 있다. 다만 Qwant의 수치는 OVHcloud가 밝힌 도입 효과이지, 토리스가 측정한 값이 아니다.
라이선스와 시작 전 체크리스트
라이선스는 Apache 2.0이다. 가중치·베이스 모델·기술 보고서·AI Act 준수 문서까지 함께 공개됐고, 패밀리에는 베이스·SFT·최종 모델 외에 요약 특화(Olala-v1.0-summarise)·번역 특화(Olala-v1.0-translate) 모델도 있다.
API 무료 시작 범위로 내 작업을 먼저 돌려보고, 추론 노력은 기본 medium부터 시작한다. 로컬로 옮길 때는 포크 버전으로 접근한다. v1.1(연말, 128K 컨텍스트) 계획도 있으니 32K 한계를 염두에 둔다.
토리스의 판단
토리스는 Olala mini를 "최고 성능 모델"이 아니라 "내 서버에 두고 돌리는 기본값 후보"로 본다.
- 먼저 붙일 곳: 도구 호출이 반복되는 에이전트·워크플로, 사내 문서 요약·번역, 데이터가 외부로 나가면 안 되는 온프레미스 어시스턴트. 8GB GPU·CPU에서도 돌아가고, Apache 2.0이라 상용 조건 걱정이 적다.
- 조심할 곳: 경쟁 수학·고난도 추론이 중심인 작업. AIME 2026 52.7점, GPQA Diamond 50.5점은 같은 크기 상위 모델보다 낮다. 한국어 이해도 영어·주요 유럽어보다 약하다고 모델 카드가 명시했으니 직접 테스트가 필수다.
- 실행 순서: API로 먼저 써 보고, 로컬은 MLX나 GGUF 포크 버전으로. MAI Code 2와 Flash처럼 호스팅 전용 저가 모델과 달리, 가중치가 공개돼 "가격이 올라도, API가 막혀도, 내 서버로 옮길 길이 있다"는 보험이 이 모델의 진짜 차별점이다.
출처
광고
YOUTUBE · TORIS STUDIO
토리스 영상 더 보기
동영상
-
 코딩 에이전트를 폰으로 조종까지..오늘 깃허브를 뒤집은 오픈소스 TOP 10 (11.18 트렌딩)
-
 코딩 에이전트를 여러 개 돌리는 법까지..오늘 깃허브를 뒤집은 오픈소스 TOP 10 (11.17 트렌딩)
-
 에이전트를 앱 화면에 꽂는 법까지..오늘 깃허브를 뒤집은 오픈소스 TOP 10 (11.16 트렌딩)
-
 에이전트 토큰 확 줄이는 법까지..오늘 깃허브를 뒤집은 오픈소스 TOP 10 (11.15 트렌딩)
-
 AI 에이전트에 '스킬'을 입혀라..오늘 깃허브를 뒤집은 오픈소스 TOP 10 (11.14 트렌딩)
-
 알리바바가 사내 AI 코드 리뷰어를 풀었다..오늘 깃허브를 뒤집은 오픈소스 TOP 8 (11.13 트렌딩)
-
 클로드 페이블 5.2, 점수만 보고 쓰면 비용이 터집니다 | 에포트 High vs Max 공식 가이드
-
 오늘 깃허브를 뒤집은 오픈소스 TOP 9 (11.12) | 메타 Astryx·구글·오픈AI 깃허브 트렌딩 총정리
쇼츠
-
 구글 말고 사람들 진짜 반응 검색? 깃허브 트렌딩 2위 오픈소스 last30days 🔎
-
 프롬프트 한 줄로 3D 게임 완성? AI 앱 홀리몰리 🎮
-
 헤이젠 아바타 6, 84%가 진짜 사람이랑 구별 못 했대요 🤯
-
 구글 제미나이 태스크, 한국에서도 드디어 무료로 풀렸어요 🔥
-
 오픈AI가 GPT-6.2를 둘로 나눴어요. 아스트라와 솔, 뭐가 다를까? 🔥
-
 코딩 에이전트 여러 개를 동시에? 깃허브 트렌딩 2위 오픈소스 Orca 🐋
-
 노트북LM이 웹사이트를 만들어준다고? 제미나이 노트북 'make me a site' 🔥
-
 맥 용량 범인은 AI 모델? 로컬 모델·캐시까지 싹 정리하는 오픈소스 MangoDisk 💾