스트라이프 벤치마크: 코딩 에이전트 결제 연동, 78%와 29%의 간극
스트라이프가 11월 19일 공개한 코딩 에이전트 벤치마크: 69개 결제 연동 시나리오에서 평균 78.1%였지만 필수 기준 전부 통과는 29.4%에 그쳤다. 플러그인 효과와 분야별 점수를 정리했다.
Q. 코딩 에이전트에 결제 연동을 맡기면, 진짜로 쓸 만한 코드가 나올까요? 스트라이프가 11월 19일 공개한 벤치마크에 따르면, 겉보기 점수는 평균 **78.1%**로 높지만 필수 기준을 전부 통과한 비율은 **29.4%**에 그칩니다. 코드는 돌아가는데 마지막 1마일에서 놓치는 게 많다는 뜻입니다. 다만 공식 플러그인을 끼우면 14개 조합이 전부 점수가 올랐고, 웹 검색은 96% 줄었습니다.
⚠️ 정확도 가드레일: 이 글은 2026년 11월 22일 기준이다. 모든 수치는 스트라이프 공식 블로그 글(2026-11-19 발행)을 직접 열어 확인했다. 비용·소요 시간은 같은 글 표 1의 실행 1회당 수치다.
30초 요약
- 무엇을 쟀나: 코딩 에이전트의 결제 연동 실력을 재는 공개 벤치마크다. 일회성 결제 24개, 구독 26개, Connect 19개, 총 69개 시나리오에 모델·하네스 14개 조합을 각각 276번 실행했다.
- 핵심 결과: 부분 점수를 합친 평균은 **78.1%**였지만, 필수 기준(MUST)을 전부 통과해야 하는 엄격 통과율은 **29.4%**로 떨어진다. 거의 맞은 코드가 대부분이라는 뜻이다.
- 플러그인 효과: 스트라이프 에이전트 플러그인을 쓰면 14개 조합이 전부 3~8%p 상승했고, 웹 검색은 건당 1.26회에서 0.05회로 96% 감소했다. 낡은 파라미터 참조도 7%에서 1.3%로 줄었다.
- 분야별 차이: 구독이 가장 어렵다. 플러그인을 써도 최고 점수가 84%에 그쳤고, Connect는 플러그인 효과가 가장 컸다.
- 실무 결론: 결제 코드는 에이전트에 맡겨도 되지만, 프로덕션 키 전에 필수 기준 체크리스트로 직접 검수해야 한다.
벤치마크는 어떻게 재는가 — 69개 시나리오, 에이전트당 276번 실행
스트라이프 evals는 "코드가 돌아가느냐"가 아니라 "연동이 올바르냐"를 본다.
기존 코딩 벤치마크는 결정적 테스트를 통과하는지만 본다. 하지만 결제 연동은 테스트를 통과해도 낡은 API를 쓰거나 웹훅 중복 처리를 빼먹을 수 있다. 스트라이프는 그래서 실제 개발자처럼 행동하는 롤플레이어 에이전트를 붙였다. 롤플레이어는 요구사항을 다 알려주지 않고, 숨겨진 필요(예: 건당 0.50달러 과금의 단위 경제성)를 대화 중에 하나씩 꺼내며 에이전트를 유도한다. 코드만 보고 판단하지 않고, 대화 기록과 작업 결과물을 함께 채점한다.
채점 기준은 RFC 2119 용어로 MUST(필수)와 SHOULD(권장)로 나뉜다. 평균 점수는 둘을 합친 부분 점수 평균이고, 엄격 통과율은 MUST를 하나라도 놓치면 0점이다. 시나리오당 45분 제한이 있고, 시간 초과는 점수에서 제외한다. 심사 모델은 전 구간 GPT-6.1 Sol을 썼고, Opus를 심사자로 쓴 대조 실험에서는 점수가 일제히 관대해졌을 뿐 순위는 같았다.
하네스는 Claude Code·Codex·OpenCode 3종, 모델은 Opus 5.5·Fable 5.2·GPT-6 Astra·Gemini 4 Argon·Kimi K3·GLM 5.3 등 14개 조합이다. 벤치마크와 평가 하네스는 GitHub(stripe/forge)에 공개됐고, 결과는 주기적으로 갱신한다고 한다.
평균 78.1%인데 엄격 통과는 29.4% — 마지막 1마일이 문제다
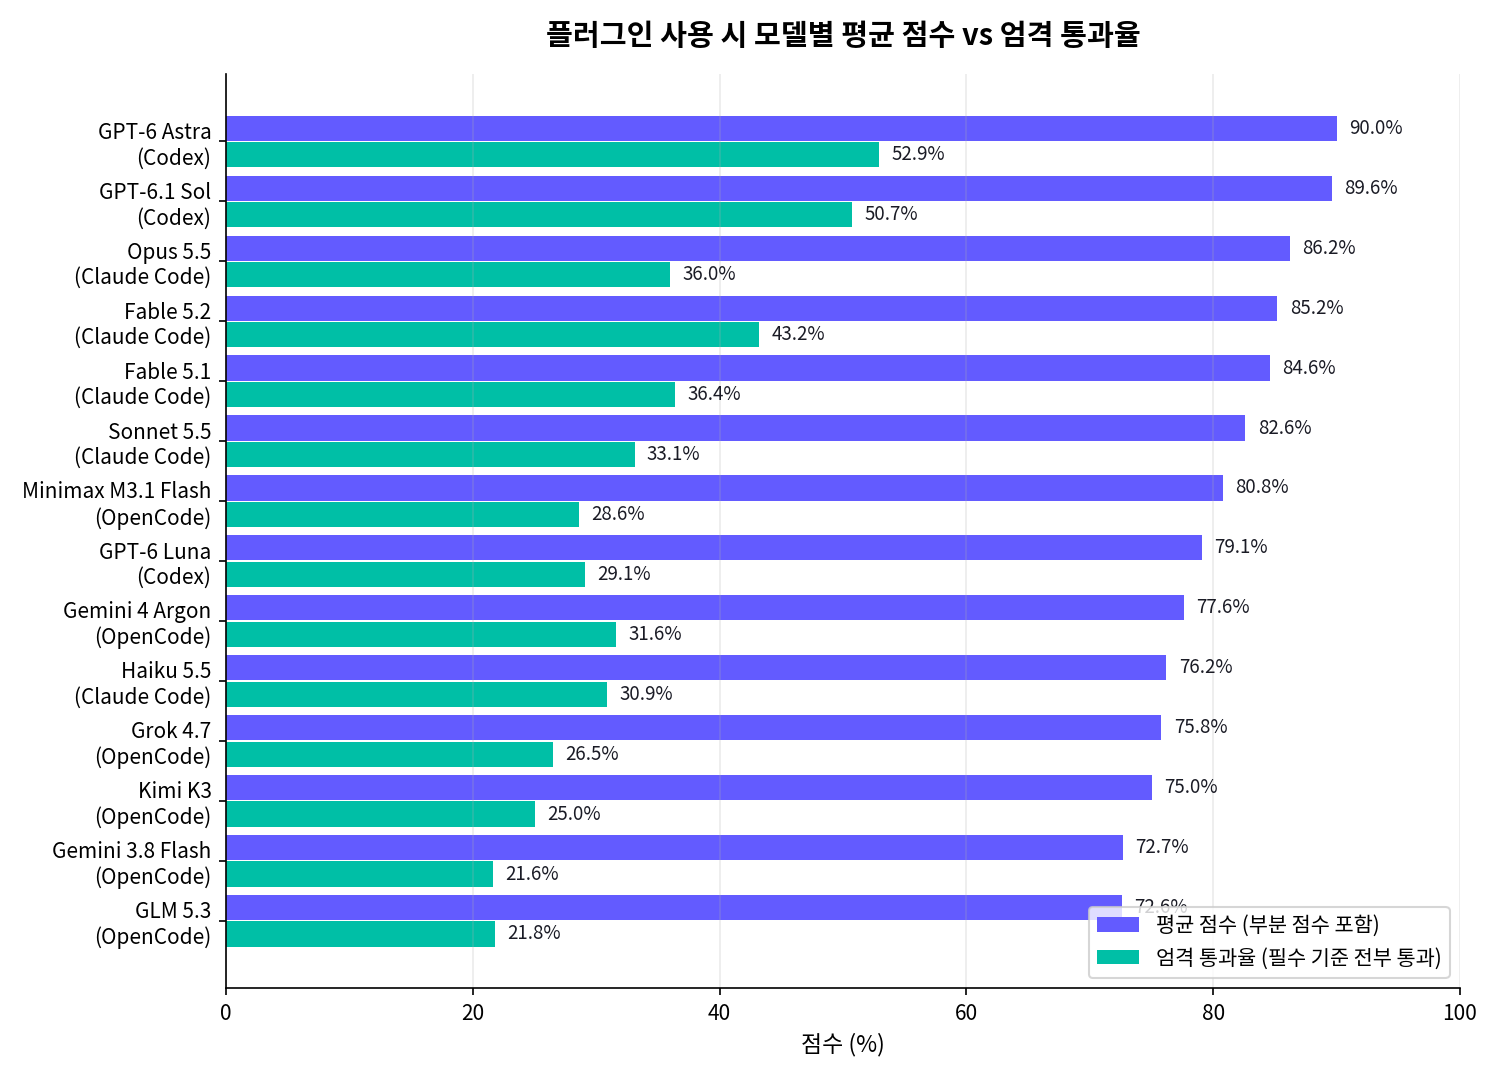
가장 잘한 조합도 엄격 통과율은 52.9%다. "거의 맞았다"가 결제에서는 "틀렸다"와 같다.
플러그인을 쓴 기준, 평균 점수 1위는 Codex + GPT-6 Astra 90.0%, 2위는 Codex + GPT-6.1 Sol **89.6%**다. 하지만 엄격 통과율로 보면 Astra 52.9%, Sol **50.7%**로 절반 수준이고, Claude Code + Fable 5.2는 평균 85.2%인데 엄격 통과율은 43.2%다. 평균 78.1%에서 엄격 통과율 29.4%로 떨어지는 간극이 이 벤치마크의 핵심 메시지다.
대표적인 실패 사례도 공개됐다. Opus 5.5는 payments-radar-review-fulfillment 시나리오에서 PaymentIntent.status === 'succeeded'만 확인하고 주문이 발송 가능한 상태인지 검사하지 않았다. 환불이나 분쟁 이후의 주문도 발송될 수 있는 코드다. 테스트는 통과한다. 돈이 새는 코드다.
비용도 함께 봐야 한다. 실행 1회당 비용은 GPT-6 Luna가 0.05달러로 가장 쌌고, Fable 5.2는 5.76달러로 가장 비쌌다. 소요 시간은 조합마다 5.1분에서 28.2분까지 벌어진다.
플러그인을 끼우면 14개 조합 전부 상승, 웹 검색 96% 감소
공식 플러그인은 점수보다, 에이전트가 "인터넷에서 주워 온 낡은 지식"을 쓰지 않게 막는 효과가 크다.
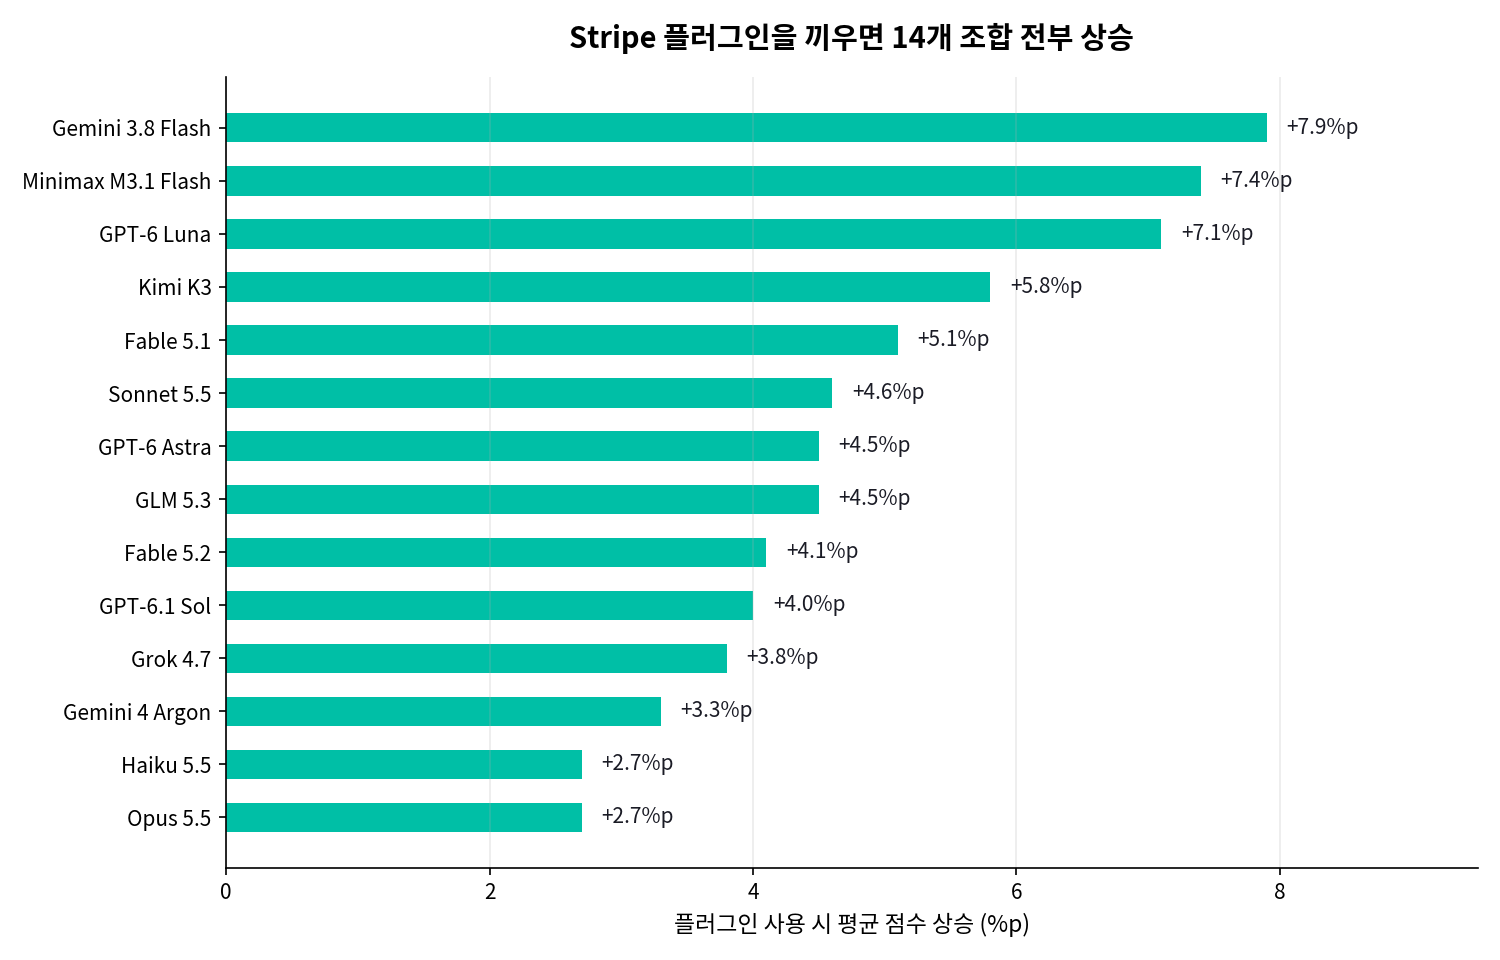
스트라이프 에이전트 플러그인은 MCP 서버와 스킬로, 공식 문서 검색과 구현 계획 도구를 에이전트에 준다. 플러그인을 쓰면 14개 조합이 전부 3~8%p 올랐다. 상승폭이 가장 큰 건 Gemini 3.8 Flash +7.9%p, Minimax M3.1 Flash +7.4%p, GPT-6 Luna +7.1%p 순이다. 이미 점수가 높은 Astra(+4.5%p)나 Opus 5.5(+2.7%p)보다, 약한 모델이 더 크게 좋아졌다.
숫자보다 눈에 띄는 건 행동 변화다. 웹 검색은 평가 1회당 1.26회에서 0.05회로 96% 줄었고, 페이지 가져오기도 4.84회에서 1.78회로 63% 줄었다. 낡은 파라미터 참조는 7%에서 1.3%로 떨어졌다. 구체적인 예도 있다. GPT-6.1 Sol은 플러그인 없이 payment_method_types: ['card']라는 이미 제거된 파라미터를 썼지만, 플러그인을 쓰자 automatic_payment_methods: { enabled: true }로 바로잡았다. 테스트 코드도 약 40% 줄었고, 테스트를 실행한 평가 비율도 53%에서 42%로 낮아졌다. 공식 안내가 있으니 과도하게 확인하지 않아도 됐다는 해석이다.
구독이 가장 어렵고 Connect가 플러그인 효과를 가장 크게 받는다
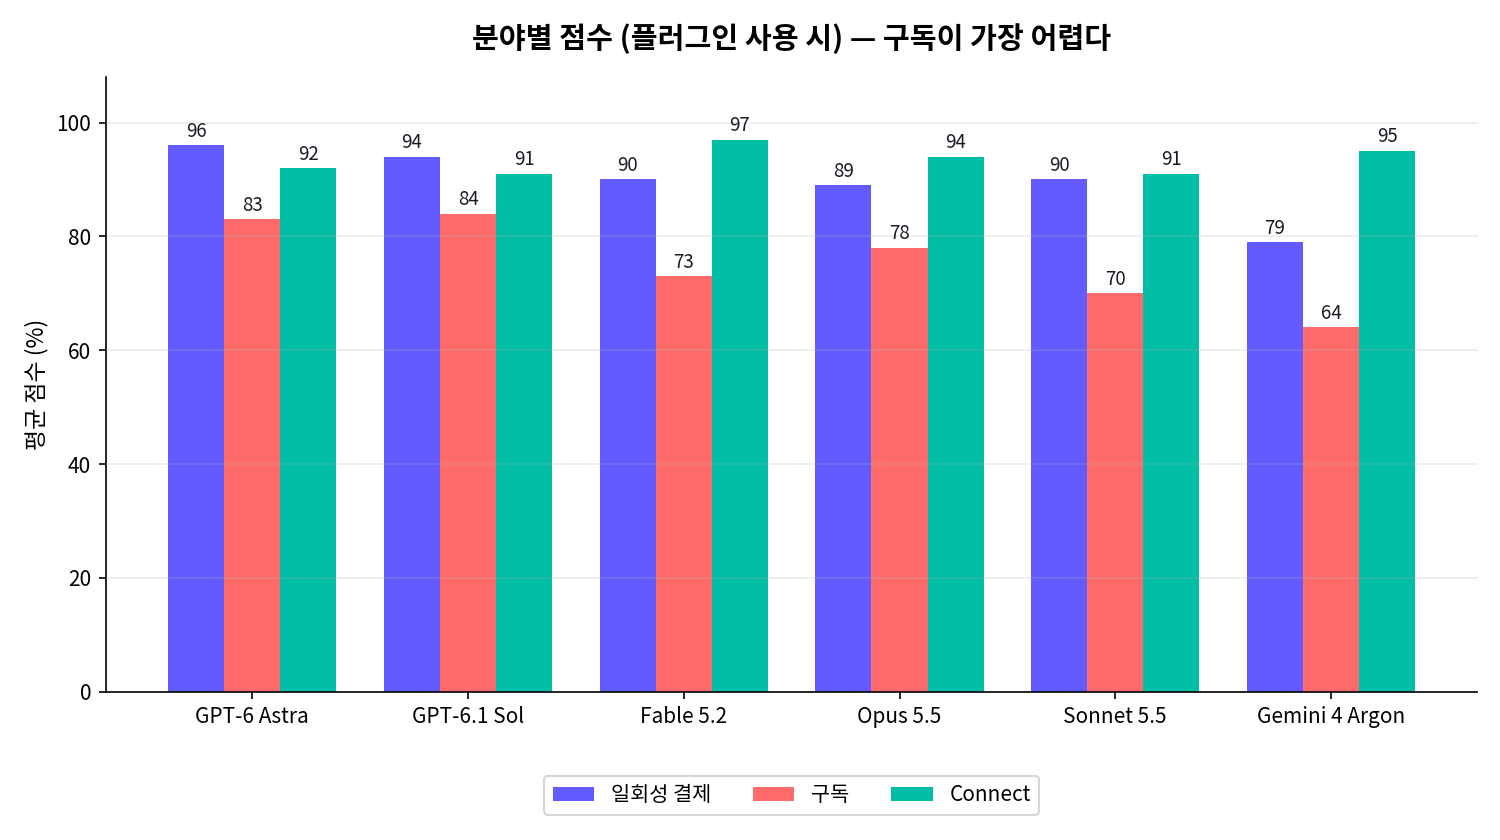
일회성 결제는 90%대, 구독은 80%대 초반이 한계다. 구독 로직이 에이전트에게 가장 어려운 영역이다.
분야별 점수(플러그인 사용 시)는 차이가 뚜렷하다. 일회성 결제는 Astra 96%, Sol 94%로 높고, Connect도 Fable 5.2가 97%, Gemini 4 Argon이 95%를 찍었다. 반면 구독은 최고 점수가 Sol의 84%에 그쳤고, Gemini 4 Argon은 64%다. 구독 시나리오는 가격 허용 목록, 멱등성 키, 웹훅 중복 제거 같은 실무 로직이 얽혀 있어 부분 점수를 깎아먹기 쉽다.
실무에서 바로 쓰는 법 — 플러그인 설치와 검수 체크리스트
결제 코드는 에이전트에 맡기되, 프로덕션 키 전에 이 순서로 검수한다.
- 플러그인부터 깐다. 쓰는 하네스(Claude Code·Codex·OpenCode)에 스트라이프 에이전트 플러그인을 설치한다. 공식 문서와 MCP 도구가 에이전트 손에 들어가야 낡은 API 참조가 줄어든다.
- 테스트 키로만 실행한다. 에이전트에게는 테스트 모드 키만 준다. 프로덕션 키는 검수를 통과한 뒤 사람이 직접 넣는다.
- MUST 체크리스트를 직접 만든다. 내 기능의 필수 기준을 먼저 적는다. 구독이면 멱등성 키, 웹훅 중복 제거, 해지·환불 후 접근 차단 같은 항목이다. 에이전트 결과물을 이 목록으로 대조한다.
- 환불·분쟁 경로를 따로 테스트한다. 결제 성공 후 환불·분쟁이 난 주문이 발송되지 않는지, 구독 해지 후 과금이 멈추는지 같은 실패 경로를 시나리오로 만들어 확인한다.
- 분야 점수로 모델을 고른다. 일회성 결제면 Astra·Sol, Connect면 Fable 5.2, 구독이면 Sol이 상대적으로 낫다. 전체 평균 1위만 보고 고르지 않는다.
코딩 에이전트 하네스 자체가 궁금하다면 토리스 블로그의 Codex CLI 0.171.0 정리와 Claude Code 실험 기능 정리도 함께 보면 된다.
토리스의 판단
이 벤치마크는 "에이전트가 결제를 못한다"는 얘기가 아니다. 평균 78%는 이미 실무에 쓸 만한 수준이고, 플러그인을 끼우면 90%까지 간다. 문제는 그 안에 숨어 있는 필수 기준 하나다. 결제에서 필수 기준 하나를 놓치면 테스트는 통과해도 돈이 새거나, 고객이 환불받고도 상품을 받는 일이 생긴다.
그래서 결론은 단순하다. 결제 연동은 에이전트에게 맡기되, 검수는 사람이 한다. 플러그인은 실수를 줄여주는 안전장치지, 검수를 대신해주는 도구가 아니다. MUST 체크리스트를 먼저 쓰고, 실패 경로를 테스트하고, 프로덕션 키는 마지막에 넘기는 순서만 지키면 된다.
출처
광고
YOUTUBE · TORIS STUDIO
토리스 영상 더 보기
동영상
-
 코딩 에이전트를 폰으로 조종까지..오늘 깃허브를 뒤집은 오픈소스 TOP 10 (11.18 트렌딩)
-
 코딩 에이전트를 여러 개 돌리는 법까지..오늘 깃허브를 뒤집은 오픈소스 TOP 10 (11.17 트렌딩)
-
 에이전트를 앱 화면에 꽂는 법까지..오늘 깃허브를 뒤집은 오픈소스 TOP 10 (11.16 트렌딩)
-
 에이전트 토큰 확 줄이는 법까지..오늘 깃허브를 뒤집은 오픈소스 TOP 10 (11.15 트렌딩)
-
 AI 에이전트에 '스킬'을 입혀라..오늘 깃허브를 뒤집은 오픈소스 TOP 10 (11.14 트렌딩)
-
 알리바바가 사내 AI 코드 리뷰어를 풀었다..오늘 깃허브를 뒤집은 오픈소스 TOP 8 (11.13 트렌딩)
-
 클로드 페이블 5.2, 점수만 보고 쓰면 비용이 터집니다 | 에포트 High vs Max 공식 가이드
-
 오늘 깃허브를 뒤집은 오픈소스 TOP 9 (11.12) | 메타 Astryx·구글·오픈AI 깃허브 트렌딩 총정리
쇼츠
-
 구글 말고 사람들 진짜 반응 검색? 깃허브 트렌딩 2위 오픈소스 last30days 🔎
-
 프롬프트 한 줄로 3D 게임 완성? AI 앱 홀리몰리 🎮
-
 헤이젠 아바타 6, 84%가 진짜 사람이랑 구별 못 했대요 🤯
-
 구글 제미나이 태스크, 한국에서도 드디어 무료로 풀렸어요 🔥
-
 오픈AI가 GPT-6.2를 둘로 나눴어요. 아스트라와 솔, 뭐가 다를까? 🔥
-
 코딩 에이전트 여러 개를 동시에? 깃허브 트렌딩 2위 오픈소스 Orca 🐋
-
 노트북LM이 웹사이트를 만들어준다고? 제미나이 노트북 'make me a site' 🔥
-
 맥 용량 범인은 AI 모델? 로컬 모델·캐시까지 싹 정리하는 오픈소스 MangoDisk 💾