MiniMind-3(64M) — PyTorch 네이티브로 2시간 만에 0부터 LLM 직접 학습하기
67.5K 스타 오픈소스 jingyaogong/minimind의 64M Dense·198M MoE 스펙, 단일 RTX 3090 기준 2시간·3위안 조건의 실제 의미, Pretrain부터 GRPO·CISPO·Agentic RL까지 전 과정을 정리했습니다.
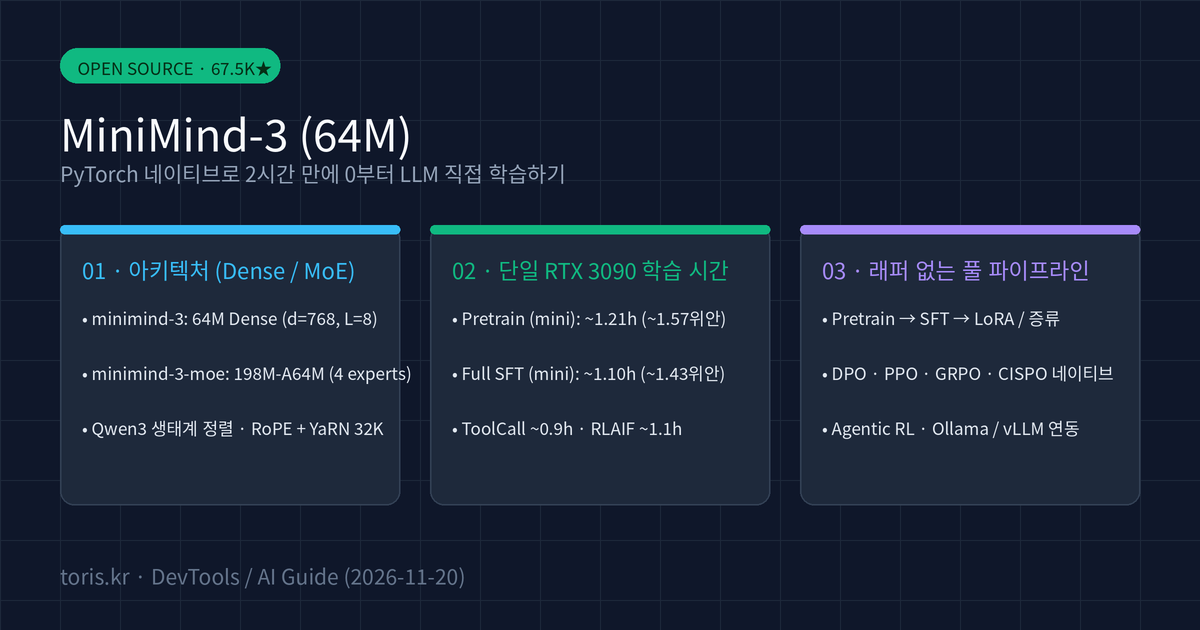
Q. MiniMind를 쓰면 정말 일반 PC나 단일 GPU에서 2시간 만에 나만의 LLM을 처음부터 학습할 수 있나요? 네, 가능합니다. 다만 공식 README가 말하는 "2시간·3위안(약 600원)"은 전체 파이프라인이 아니라 단일 NVIDIA RTX 3090에서
minimind-3(64M) SFT(mini 데이터셋) 1 epoch를 돌린 실측 기준입니다. Pretrain부터 SFT·ToolCall·RLAIF까지 전 과정을 밟아도 단계별로 1~1.5시간 안팎이라 개인 개발자가 부담 없이 LLM 내부 구조를 코드 한 줄씩 뜯어보며 완주할 수 있습니다.
⚠️ 정확도 가드레일: 이 글은 2026년 11월 20일 기준 jingyaogong/minimind 공식 GitHub 저장소(Stars 67,494, Apache-2.0)와 토리스 스튜디오 유튜브 11월 18일 깃허브 트렌딩 톱 10 영상을 직접 대조해 작성했습니다. GPU 렌탈 단가(시간당 1.3위안 기준)와 학습 소요 시간은 공식 저장소가 제시한 단일 RTX 3090 경험적 추정치이며, 실제 환경·데이터셋 크기에 따라 달라집니다.
30초 요약
- 래퍼 없는 순수 PyTorch 구현:
transformers,trl,peft같은 고수준 추상화 라이브러리 없이 토크나이저부터 모델, LoRA, DPO, PPO, GRPO, CISPO, Agentic RL까지 직접 구현했습니다. - 초경량
minimind-3스펙: 64M Dense 모델(d_model=768,n_layers=8,q_heads=8,kv_heads=4, RoPE + YaRN 32K)과 198M-A64M MoE(4 experts / top-1)를 제공하며Qwen3생태계와 구조를 맞췄습니다. - 실제 시간·비용 범위: 단일 RTX 3090 기준 mini 데이터셋 Pretrain 약 1.21시간(1.57위안), SFT 약 1.10시간(1.43위안), ToolCall 약 0.9시간(1.17위안), RLAIF 약 1.1시간(1.43위안) 수준입니다.
- 로컬 추론 생태계 호환: 학습이 끝난 가중치는
ollama run jingyaogong/minimind-3,vLLM,llama.cpp, OpenAI API 호환 서버(serve_openai_api.py), Streamlit WebUI로 바로 띄울 수 있습니다.
MiniMind는 왜 transformers와 peft를 쓰지 않았을까
MiniMind는 단순히 작은 모델을 배포하는 프로젝트가 아니라, LLM이 바닥부터 만들어지는 전체 과정을 가리지 않고 보여 주는 교육·실험용 오픈소스입니다.
보통 실무에서 파인튜닝을 할 때는 transformers나 peft, trl을 불러와 십여 줄의 코드로 학습을 끝냅니다. 편리하지만, 그만큼 어텐션 마스크가 어떻게 흐르는지, RoPE 회전 위치 인코딩이 QK에 어떻게 적용되는지, LoRA나 DPO의 손실 함수가 실제로 어떤 텐서 연산으로 떨어지는지는 블랙박스 안에 남습니다. MiniMind(jingyaogong/minimind)는 이 장벽을 없애기 위해 핵심 모델(model_minimind.py)과 학습 루프(trainer/)를 전부 네이티브 PyTorch로 직접 작성했습니다.
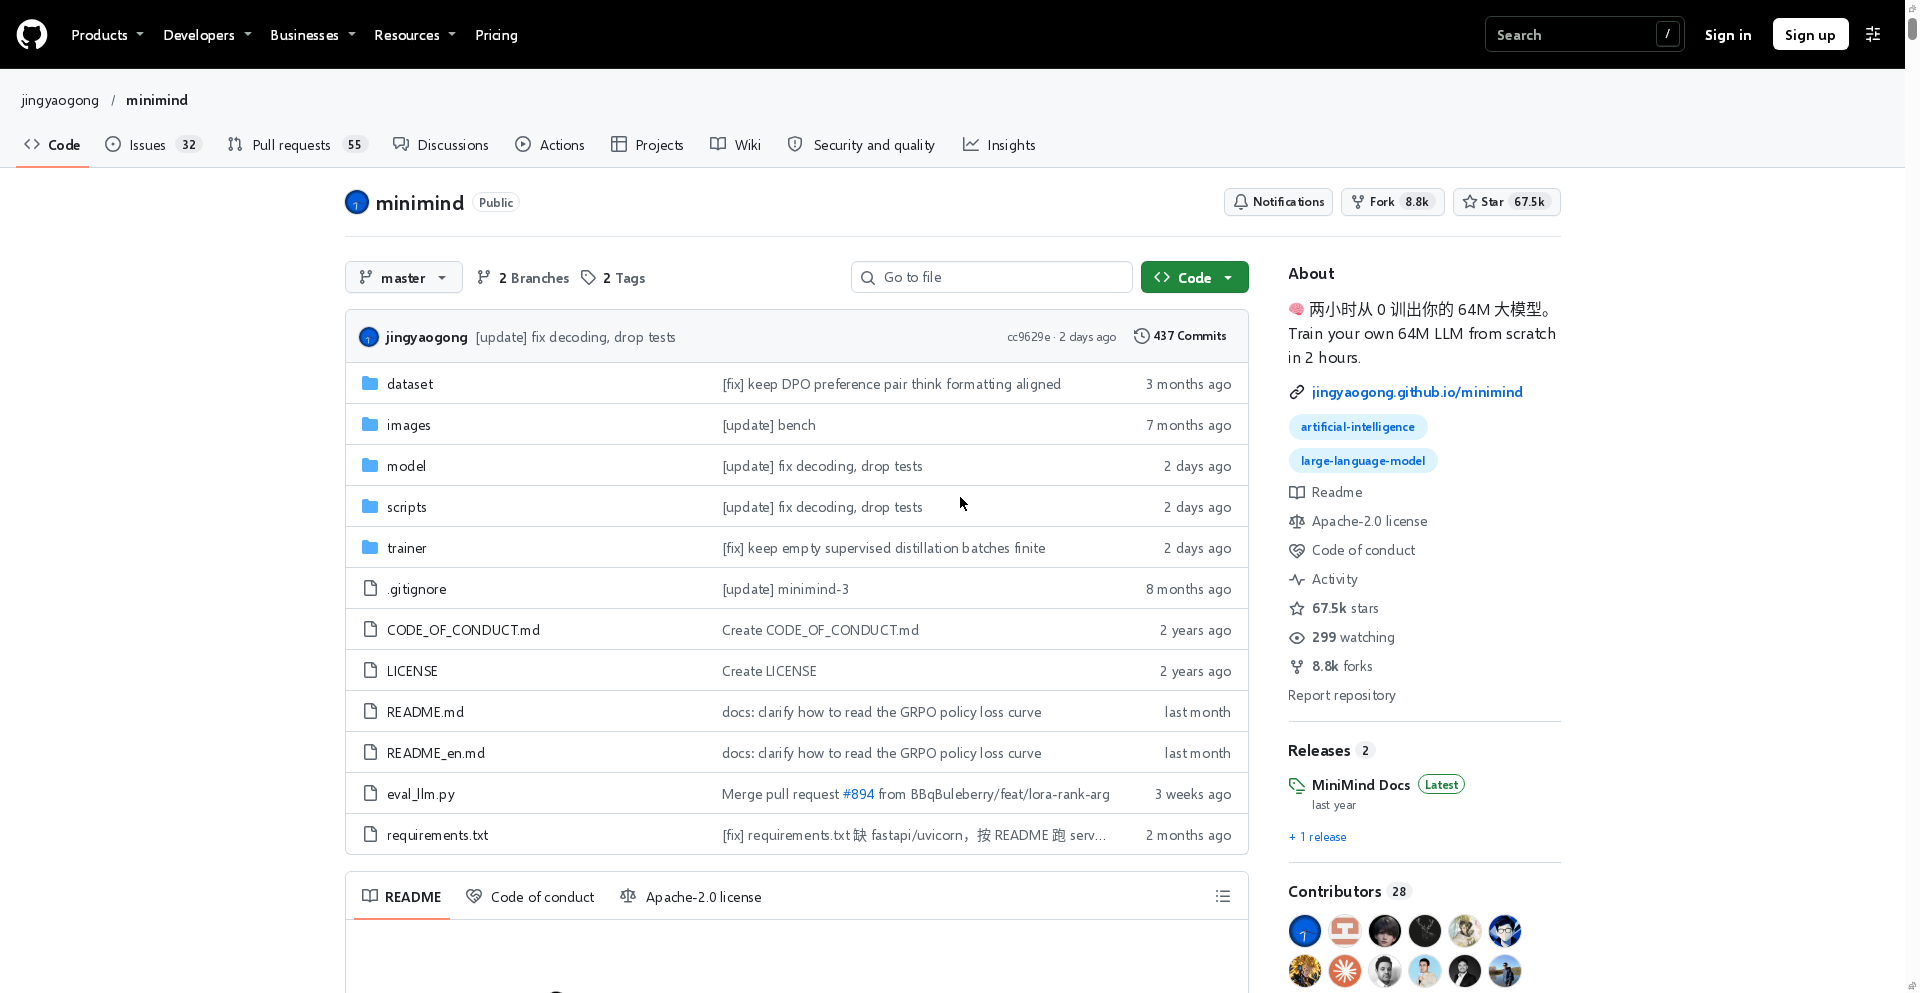
2026년 4월 1일 공개된 minimind-3는 구조 면에서도 실용적인 변화를 택했습니다. 기존 v1·v2에서 독자 구조를 쓰던 것에서 벗어나 Qwen3 / Qwen3-MoE 생태계로 파라미터 네이밍과 아키텍처를 정렬했습니다. 덕분에 직접 학습한 모델을 Hugging Face 포맷으로 내보내 llama.cpp, vLLM, Ollama 같은 표준 추론 엔진에 그대로 올려 테스트할 수 있습니다.
모델 라인업과 아키텍처 스펙 비교
주력 라인업은 단일 Dense 모델인 minimind-3 (64M) 와 희소 전문가 모델인 minimind-3-moe (198M-A64M) 두 가지입니다.
| 모델 | 파라미터 | 어휘 크기 | 최대 컨텍스트 | 레이어 / 차원 | 어텐션 헤드 | 비고 |
|---|---|---|---|---|---|---|
minimind-3 |
64M | 6,400 | 32,768 (YaRN) | 8층 / 768 | Q=8, KV=4 | Dense 주력 |
minimind-3-moe |
198M-A64M | 6,400 | 32,768 (YaRN) | 8층 / 768 | Q=8, KV=4 | 4 experts / top-1 |
minimind2 |
104M | 6,400 | 32,768 (YaRN) | 16층 / 768 | Q=8, KV=2 | 2025.04 구버전 |
minimind2-small |
26M | 6,400 | 32,768 (YaRN) | 8층 / 512 | Q=8, KV=2 | 2025.04 구버전 |
흥미로운 지점은 minimind-3-moe의 설계 타협입니다. 이론상 MoE는 추론 시 활성 파라미터가 적어 빠르지만, 커스텀 Triton 커널이나 DeepSpeed-MoE 없이 순수 PyTorch로 학습할 때는 토큰을 전문가별로 분배하는 스케줄링 오버헤드가 커집니다. 저장소 저자는 순수 PyTorch의 가독성을 지키기 위해 shared expert를 제거하고 4 experts / top-1 routing으로 타협해, Dense 대비 학습 속도가 약 50% 정도만 느려지는 균형점을 찾았다고 설명합니다.
'2시간, 3위안'의 실제 조건과 단계별 학습 비용
"2시간 만에 내 LLM을 만든다"는 문구를 곧이곧대로 받아들이면 데이터 다운로드부터 강화학습까지 전부 2시간에 끝난다고 오해하기 쉽습니다. 공식 README의 각주와 실험 표를 열어 보면 실제 조건이 명확합니다.
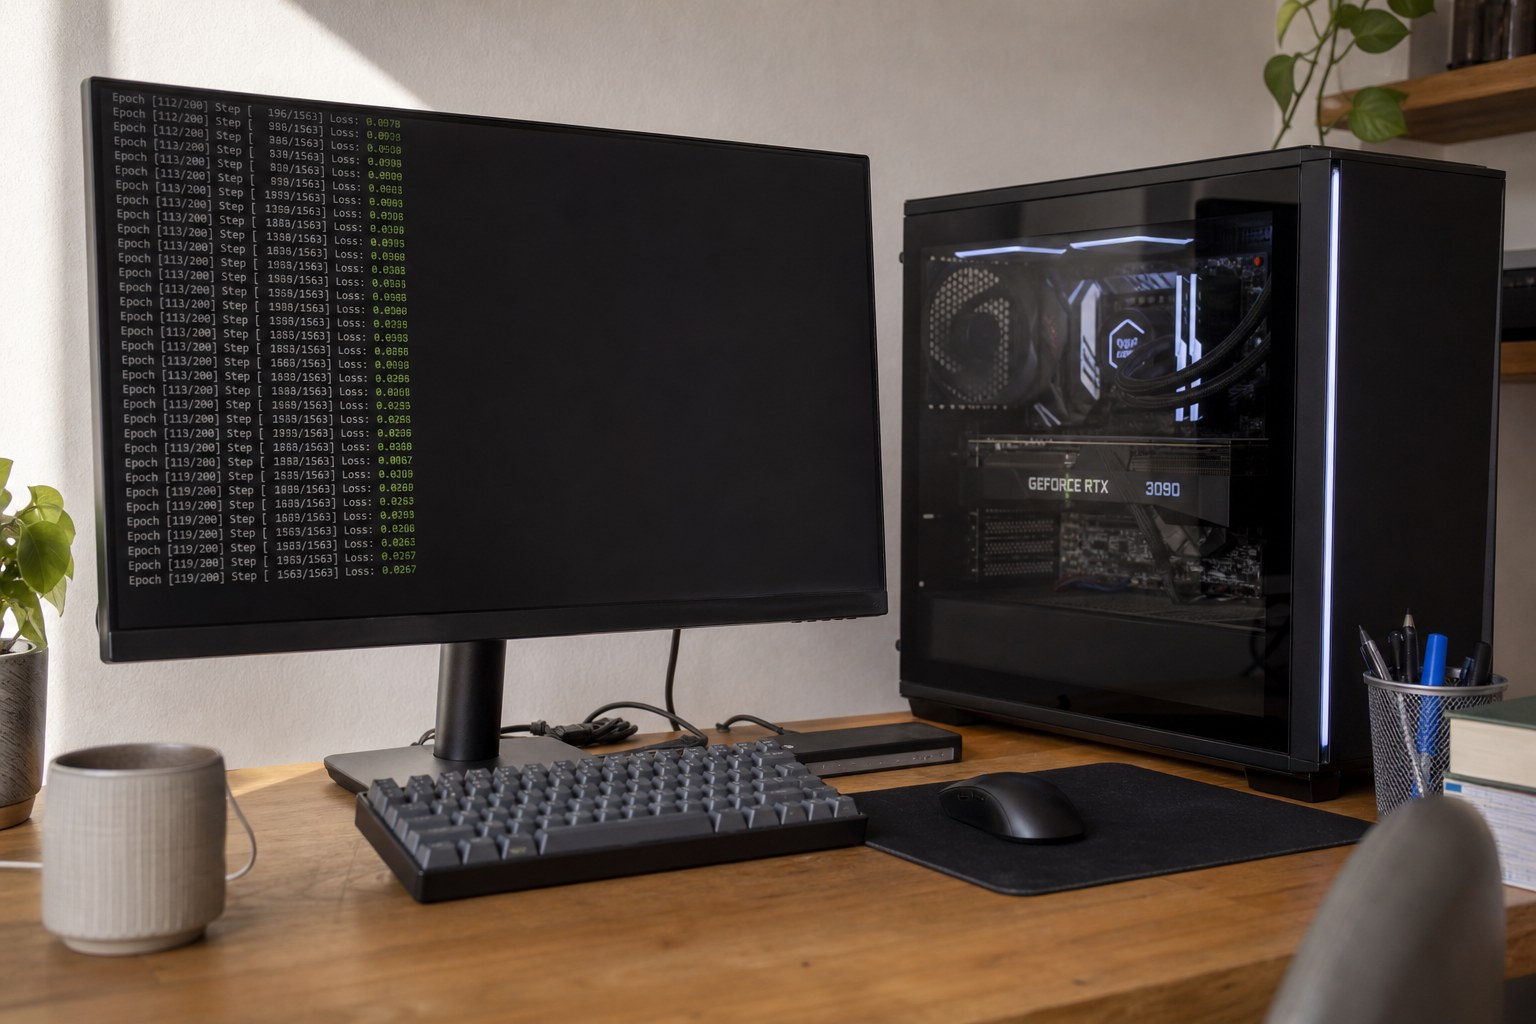
| 모델 | Pretrain (mini, 1.2GB) |
Full SFT (mini, 1.6GB) |
ToolCall | RLAIF (PPO/GRPO) |
|---|---|---|---|---|
minimind-3 (64M) |
≈ 1.21시간 (≈ 1.57위안) | ≈ 1.10시간 (≈ 1.43위안) | ≈ 0.90시간 (≈ 1.17위안) | ≈ 1.10시간 (≈ 1.43위안) |
minimind-3-moe (198M-A64M) |
≈ 1.69시간 (≈ 2.20위안) | ≈ 1.54시간 (≈ 2.00위안) | ≈ 1.26시간 (≈ 1.64위안) | ≈ 1.54시간 (≈ 2.00위안) |
기준: 단일 NVIDIA RTX 3090 (24GB), 시간당 렌탈 단가 약 1.3위안(약 7위안 ≈ 1달러) 가정,
pretrain_t2t_mini.jsonl·sft_t2t_mini.jsonl1 epoch 기준 추정치.
즉, 기본 대화 모델(MiniMind Zero)을 빠르게 재현하는 Pretrain(mini) 또는 SFT(mini) 한 단계가 각각 1~1.2시간, 합쳐서 약 2.3시간(약 3위안) 안팎이라는 뜻입니다. 만약 전체 pretrain_t2t.jsonl(10GB)과 sft_t2t.jsonl(14GB)로 풀 학습을 돌리거나 DPO·Agentic RL까지 완주하려면 그에 비례해 시간이 더 늘어납니다. 그럼에도 수억 원대 클러스터 없이 개인 GPU 한 장에서 커피 한 잔 값도 안 되는 비용으로 Pretrain부터 RL까지 전부 돌려 볼 수 있다는 점은 독보적입니다.
Pretrain부터 Agentic RL까지, 한 번에 보는 훈련 파이프라인
MiniMind 저장소가 6만 7천 개 넘는 스타를 모은 진짜 이유는 최신 후처리(Post-training) 기법까지 코드로 전부 열어 두었기 때문입니다.
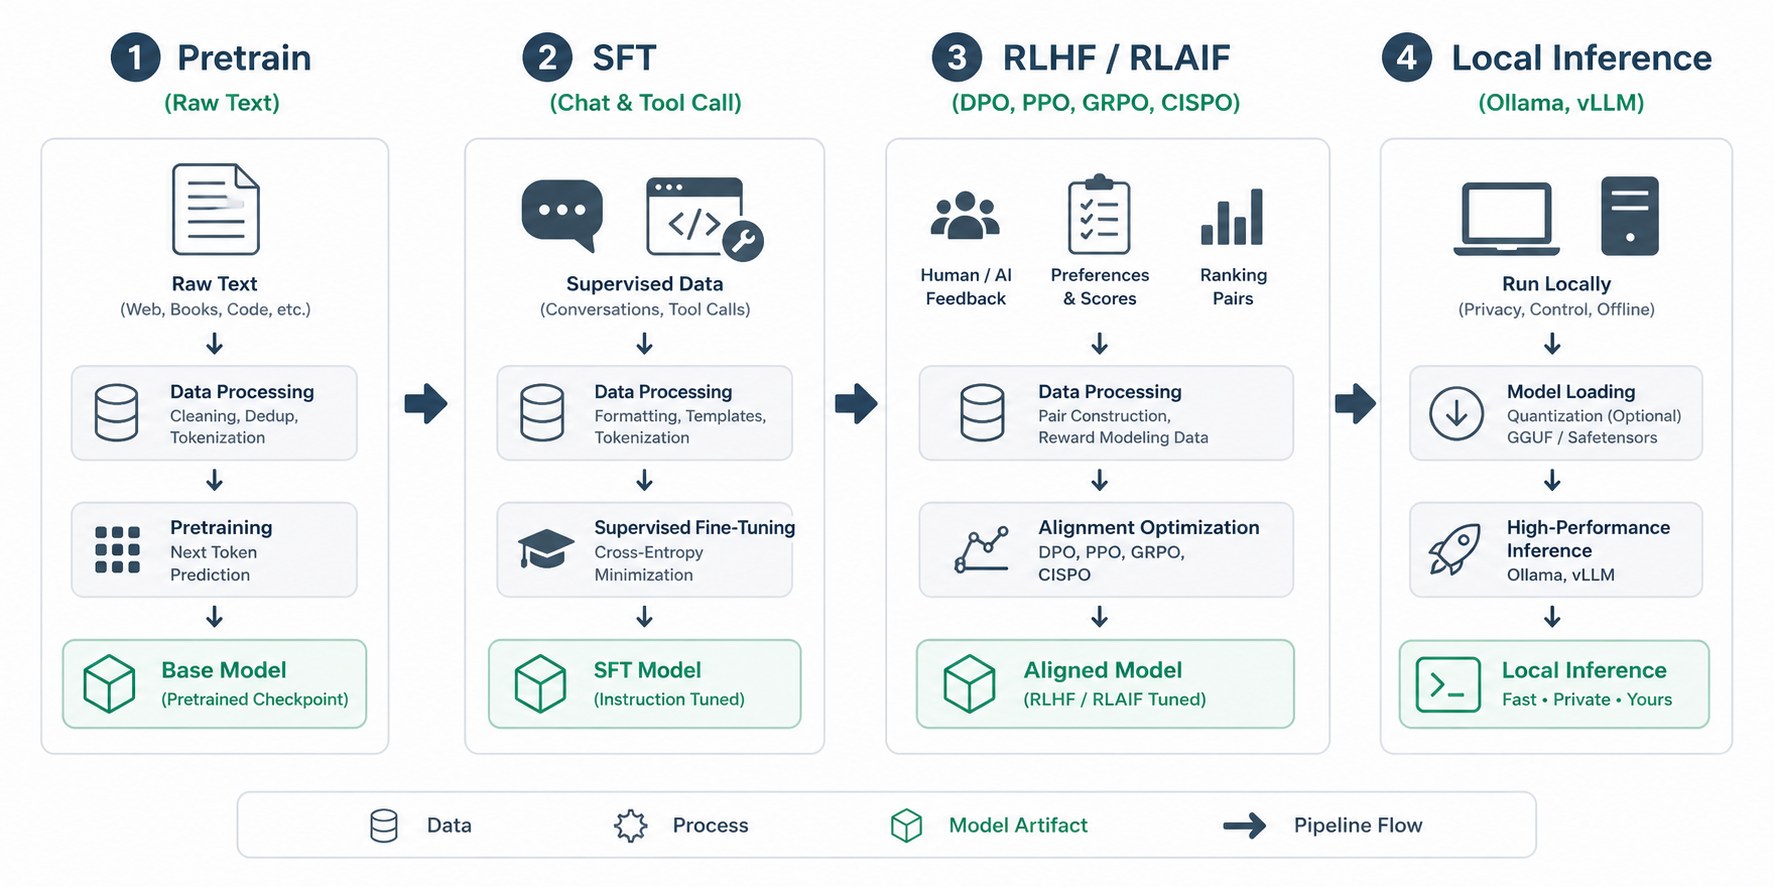
- Pretrain & Full SFT (
train_pretrain.py,train_full_sft.py): BPE + ByteLevel 토크나이저(len_vocab=6400)로 텍스트 패턴을 익힌 뒤,sft_t2t데이터셋으로 대화 템플릿과<think>적응형 사고(Adaptive Thinking),<tool_call>호출 형식을 동시에 학습합니다. - LoRA & 지식 증류 (
train_lora.py,train_distillation.py):peft없이 저랭크 어댑터를 직접 구현해 CPU에서도 가볍게 도메인 적응이 가능하며, 교사 모델의 로짓 분포(CE + KL 손실)를 따라가는 화이트박스 증류 코드도 포함합니다. - DPO · PPO · GRPO · CISPO (
train_dpo.py,train_ppo.py,train_grpo.py): 선호 데이터셋으로 학습하는 DPO부터, Critic 네트워크를 쓰는 PPO, 그룹 내 상대 보상으로 Critic을 없앤 GRPO, 그리고 클리핑 시 그래디언트가 끊기는 문제를 보완한 CISPO(loss_type=cispo)까지 한 저장소에서 비교 실험할 수 있습니다. - Agentic RL (
train_agent.py): 2026년 3월 추가된 스크립트로, 다중 턴 도구 호출 궤적(Trajectory) 전체에 지연 보상을 매깁니다.sglang서버를 rollout 엔진으로 분리해 돌릴 수도 있어 최근 대규모 RL 프레임워크(OpenRLHF, verl)의 구조를 소형 모델로 미리 맛볼 수 있습니다.
Q. 64M 모델이 실제 서비스나 상용 챗봇을 대체할 수 있나요? 아닙니다. 공식 README의 Zero 샘플 대화에서도 영어 질문에 엉뚱한 문장을 생성하는 등 사실 지식과 범용 추론 한계가 분명히 드러납니다. 64M 규모는 상용 범용 비서용이 아니라 학습 원리 체득, 도메인 특화 초소형 분류/라우터 실험, 에이전트 루프 프로토타이핑에 쓰는 것이 맞습니다.
에이전트 워크플로우에 직접 도구를 붙여 보거나 개발 리뷰 루프를 자동화하려는 분이라면 토리스 스튜디오의 Plannotator 브라우저 기반 계획·코드 리뷰 가이드나 CLI-Anything 에이전트 네이티브 하네스 정리도 함께 참고해 보시면 흐름이 잘 이어집니다.
토리스의 판단
LLM을 'API로 부르는 단계'에서 '내부 코드까지 이해하고 만지는 단계'로 넘어가고 싶은 개발자라면 지금 가장 먼저 클론해 볼 저장소입니다.
- 추천 대상: 트랜스포머·RoPE·MoE·GRPO·CISPO를 논문 수식이 아니라 실행 가능한 PyTorch 코드로 뜯어보고 싶은 분, RTX 3090·4090 한 장 또는 Colab/클라우드 GPU로 직접 Pretrain→SFT→RL을 끝까지 돌려 보고 싶은 분.
- 비추천 대상: 당장 한국어·영어 사내 문서를 정확하게 요약하거나 코딩을 대신해 줄 고성능 실무 모델을 찾는 분(이 목적이라면 Qwen·Gemma·Llama 계열의 7B 이상 사전학습 모델에 LoRA를 얹거나 상용 API를 쓰는 편이 훨씬 빠르고 정확합니다).
시작할 때는 pretrain_t2t_mini.jsonl과 sft_t2t_mini.jsonl 두 개만 먼저 받아 train_pretrain.py --from_resume 1부터 돌려 보시길 권합니다. 2시간 남짓 뒤에 직접 학습한 가중치를 ollama run으로 띄워 첫 대답을 받아 보는 경험이 가장 확실한 학습 동기 부여가 됩니다.
출처
광고
YOUTUBE · TORIS STUDIO
토리스 영상 더 보기
동영상
-
 코딩 에이전트를 폰으로 조종까지..오늘 깃허브를 뒤집은 오픈소스 TOP 10 (11.18 트렌딩)
-
 코딩 에이전트를 여러 개 돌리는 법까지..오늘 깃허브를 뒤집은 오픈소스 TOP 10 (11.17 트렌딩)
-
 에이전트를 앱 화면에 꽂는 법까지..오늘 깃허브를 뒤집은 오픈소스 TOP 10 (11.16 트렌딩)
-
 에이전트 토큰 확 줄이는 법까지..오늘 깃허브를 뒤집은 오픈소스 TOP 10 (11.15 트렌딩)
-
 AI 에이전트에 '스킬'을 입혀라..오늘 깃허브를 뒤집은 오픈소스 TOP 10 (11.14 트렌딩)
-
 알리바바가 사내 AI 코드 리뷰어를 풀었다..오늘 깃허브를 뒤집은 오픈소스 TOP 8 (11.13 트렌딩)
-
 클로드 페이블 5.2, 점수만 보고 쓰면 비용이 터집니다 | 에포트 High vs Max 공식 가이드
-
 오늘 깃허브를 뒤집은 오픈소스 TOP 9 (11.12) | 메타 Astryx·구글·오픈AI 깃허브 트렌딩 총정리
쇼츠
-
 구글 말고 사람들 진짜 반응 검색? 깃허브 트렌딩 2위 오픈소스 last30days 🔎
-
 프롬프트 한 줄로 3D 게임 완성? AI 앱 홀리몰리 🎮
-
 헤이젠 아바타 6, 84%가 진짜 사람이랑 구별 못 했대요 🤯
-
 구글 제미나이 태스크, 한국에서도 드디어 무료로 풀렸어요 🔥
-
 오픈AI가 GPT-6.2를 둘로 나눴어요. 아스트라와 솔, 뭐가 다를까? 🔥
-
 코딩 에이전트 여러 개를 동시에? 깃허브 트렌딩 2위 오픈소스 Orca 🐋
-
 노트북LM이 웹사이트를 만들어준다고? 제미나이 노트북 'make me a site' 🔥
-
 맥 용량 범인은 AI 모델? 로컬 모델·캐시까지 싹 정리하는 오픈소스 MangoDisk 💾