DaisyRose-27B: SFT 없이 RL만으로 코딩 실력 2배로 키웠다
RadixArk가 11월 18일 공개한 DaisyRose-27B는 Qwen3.8-27B를 SFT·증류 없이 강화학습만으로 학습시킨 27B 오픈웨이트 코딩 모델이다. Terminal Bench 4.1이 5.6에서 12.0으로 올랐고, 144개 H200으로 18일 학습했다.
Q. SFT 없이 강화학습만으로 코딩 모델을 키울 수 있을까요? RadixArk가 공개한 DaisyRose-27B는 그 질문에 대한 답이다. Qwen3.8-27B를 지도학습(SFT)이나 증류 없이 강화학습(RL)만으로 학습시켜, Terminal Bench 4.1 점수를 5.6에서 12.0으로 2배 이상 끌어올렸다. 1,200개 장기 에이전트 과제, 144개 H200 GPU, 18일 학습이라는 작은 규모로 만든 결과다.
⚠️ 정확도 가드레일: 이 글은 2026년 11월 22일 기준이다. 모든 수치·날짜·사양은 RadixArk 공식 블로그와 Hugging Face 모델 카드를 직접 열어 확인했다. 공개일 11월 18일은 2차 보도 기준이며, 공식 블로그에는 날짜 표기가 없다. 벤치마크 점수는 RadixArk의 자기 보고 수치다.
30초 요약
- 무엇인가: RadixArk의 첫 모델 DaisyRose-27B. Qwen3.8-27B를 SFT·증류 없이 강화학습만으로 학습시킨 27B 오픈웨이트 코딩 에이전트 모델이다. Apache 2.0 라이선스다.
- 핵심 결과: Terminal Bench 4.1 pass@1이 베이스 5.6에서 12.0으로 2배 이상 올랐다. Terminal Bench 2.1(73.0→75.5), DeepSWE v1.1(42.2→46.2), SWE Bench Pro v2(91.3→94.7) 등 측정한 7개 벤치마크가 전부 올랐다.
- 학습 규모: 약 1,200개 큐레이션 과제, 세션 최대 100만 토큰, 144개 H200 GPU로 18일, 총 약 63,000 GPU시간. 샌드박스는 약 944,000개 돌렸다.
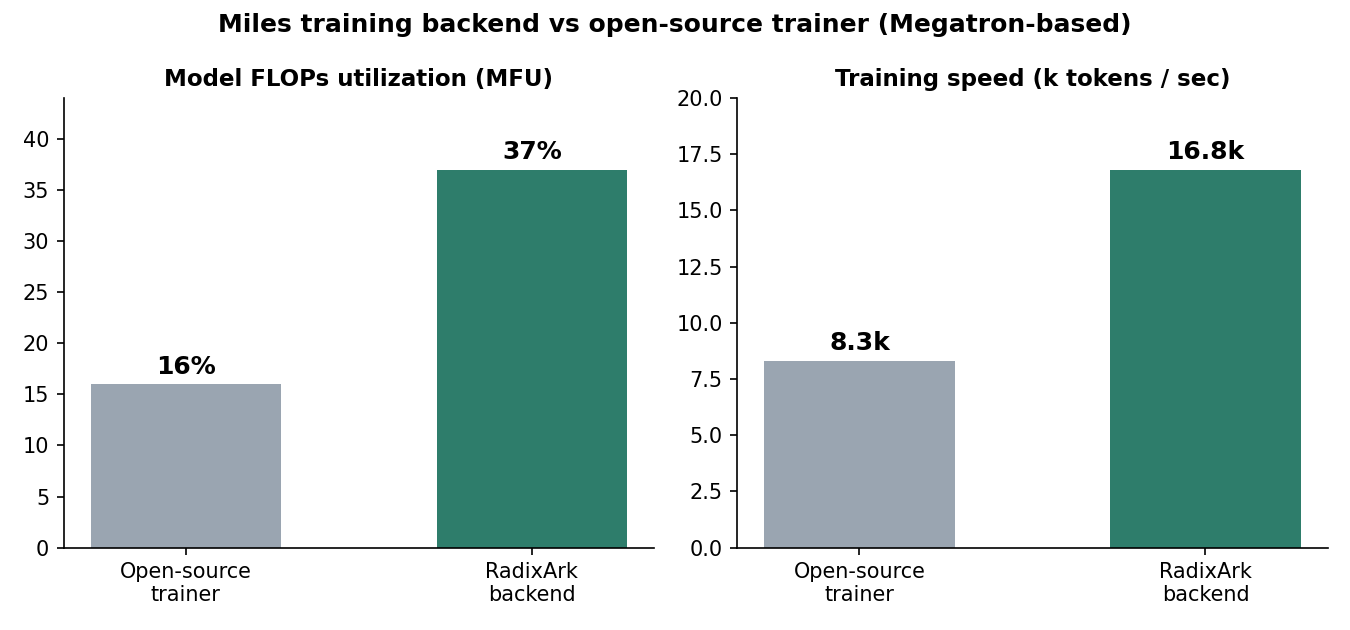
- 효율: 자체 학습 백엔드의 MFU가 **37%**로 오픈소스 트레이너(16%)의 2배 이상, 학습 속도는 초당 16.8k 토큰으로 약 2배다.
- 실행: 1개 GPU에서 돈다. BF16 약 52GB, FP8 약 29GB, NVFP4 약 23GB(Blackwell 전용). SGLang + DSpark 추론을 권장한다.
SFT도 증류도 없이, 강화학습만으로 학습했다
DaisyRose-27B의 가장 큰 특징은 학습 방법 자체다. 보통은 SFT로 형식을 잡고 RL로 다듬는데, 이 모델은 베이스 체크포인트에서 바로 RL만으로 학습했다.
학습 데이터는 Eigent AI와 함께 만든 약 1,200개 장기 에이전트 과제다. 각 과제는 여러 개의 상호 의존적인 문제로 이어진 긴 작업으로, 한 번 시도에 샌드박스에서 최대 1.5시간, 100회 넘는 도구 호출, 25만 토큰 넘는 출력이 나온다. 과제 선정 기준은 세 가지다. 베이스 모델이 실제로 틀리는 지점, 적절한 난도, 꼼수 방지다.
아키텍처는 베이스 모델 그대로다. 64개 디코더 레이어가 선형 어텐션(Gated DeltaNet) 3개와 전체 어텐션 1개의 비율로 반복되고, 총 27.8B 파라미터, 컨텍스트 262,144 토큰, 이미지 입력이 가능하다. 기존 Qwen3.8-27B 스택에 그대로 꽂아 쓸 수 있는 드롭인 대체 모델이다.
Terminal Bench 4.1이 5.6에서 12.0으로, 7개 벤치마크 전부 상승
가장 어려운 장기 벤치마크에서 2배 이상 올랐고, 나머지 6개도 전부 베이스보다 높다. 다만 절대 점수는 여전히 낮다.
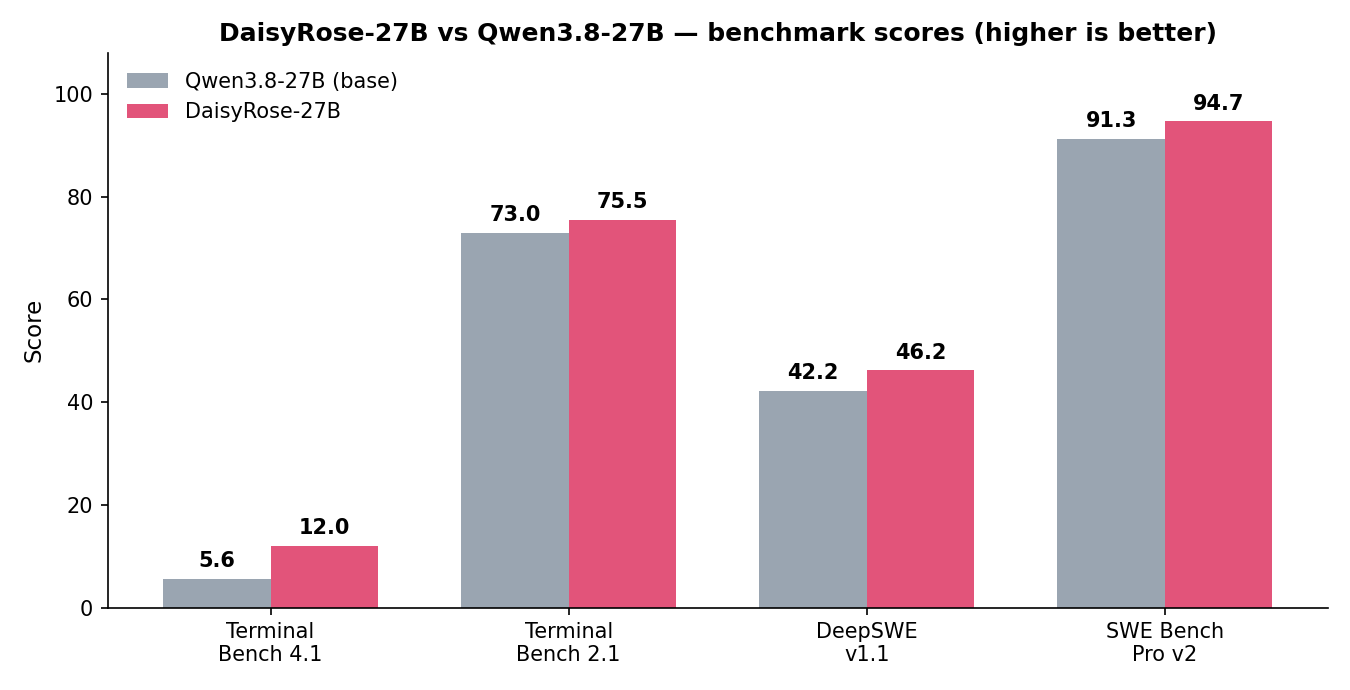
Terminal Bench 4.1 pass@1이 5.6에서 12.0으로 오른 게 대표 결과다. Terminal Bench 2.1은 73.0에서 75.5, DeepSWE v1.1은 42.2에서 46.2, SWE Bench Pro v2는 91.3에서 94.7로 올랐다. 추론·지시 분야도 올랐다. HLE(텍스트만) 33.9에서 34.3, IFBench 79.5에서 82.4, GPQA Diamond 89.2에서 90.7이다. IFBench 82.4는 비교 모델 중 가장 높은 수치다.
다만 맥락이 필요하다. Terminal Bench 4.1에서 12.0은 MiMo V2.6 Flash 16.1, GPT-6 Luna 15.2, Inkling 2 Small 13.0보다 낮다. 2배 상승은 사실이지만 프론티어급과 견주면 아직 갈 길이 멀다. 독립 벤치마크에서는 짧은 과제에서 베이스 대비 이득이 약 1점에 그친다는 지적도 있다. 이 모델의 가치는 "최고 점수"가 아니라 "RL만으로 얼마나 올릴 수 있는가"라는 레시피에 있다.
학습 효율이 핵심이다 — MFU 37%, 속도 2배
RadixArk가 이 글에서 가장 강조하는 건 점수가 아니라 학습 인프라다. 같은 학습을 57% 적은 GPU 시간으로 끝냈다고 한다.
오픈소스 RL 프레임워크 Miles를 완전 비동기 방식으로 돌렸다. 128개 H200이 SGLang으로 에이전트 추론을 돌리는 동안 16개 H200이 끝난 궤적으로 학습하고, 매 스텝마다 업데이트된 가중치를 다시 128개 GPU에 보낸다. 에이전트와 학습이 서로를 기다리지 않는 구조다.
그 결과 MFU(모델 FLOPs 활용률)가 37%로, Megatron 기반 오픈소스 트레이너의 16%보다 2배 이상 높다. 같은 학습에 GPU 시간이 57% 덜 든다는 계산이다. 학습 속도는 초당 약 16,800 토큰으로 오픈소스 트레이너(약 8,300)의 2배다. MoE 모델에서는 격차가 더 커서 Qwen3.6-35B-A3B에서 6.2배, 약 300B 파라미터 GLM-5.3-Flash에서 10배 이상이라고 한다. 18일 내내 속도와 효율이 안정적으로 유지됐다는 점도 강조했다.
944,000개 샌드박스가 RL을 지탱했다
에이전트 RL의 숨은 비용은 샌드박스다. RadixArk는 9주간 약 944,000개를 돌렸고, 피크 동시 실행은 1,566개였다.
모든 시도는 AgentENV 기반 자체 샌드박스 서비스에서 실행된다. 과제의 환경을 새로 복사해 명령 실행·파일 편집·채점을 한 뒤 버리는 방식이다. 서비스는 9주간 1대에서 최대 12대 규모로 커졌고, 10번 업그레이드했는데 대부분 학습 도중에 했다. 샌드박스 생성 성공률은 9주 평균 99%, 10월 말 이후로는 99.95%를 넘었다고 한다.
비용도 낮췄다. 클라우드 인프라 비용이 인기 샌드박스 제공업체보다 약 80% 낮았다고 한다.
직접 써보기: 1개 GPU, SGLang + DSpark 조합
27B 모델이지만 1개 GPU에서 돌아간다. H200·B200·GB300 같은 데이터센터 카드부터 RTX 5090·DGX Spark까지 지원한다.
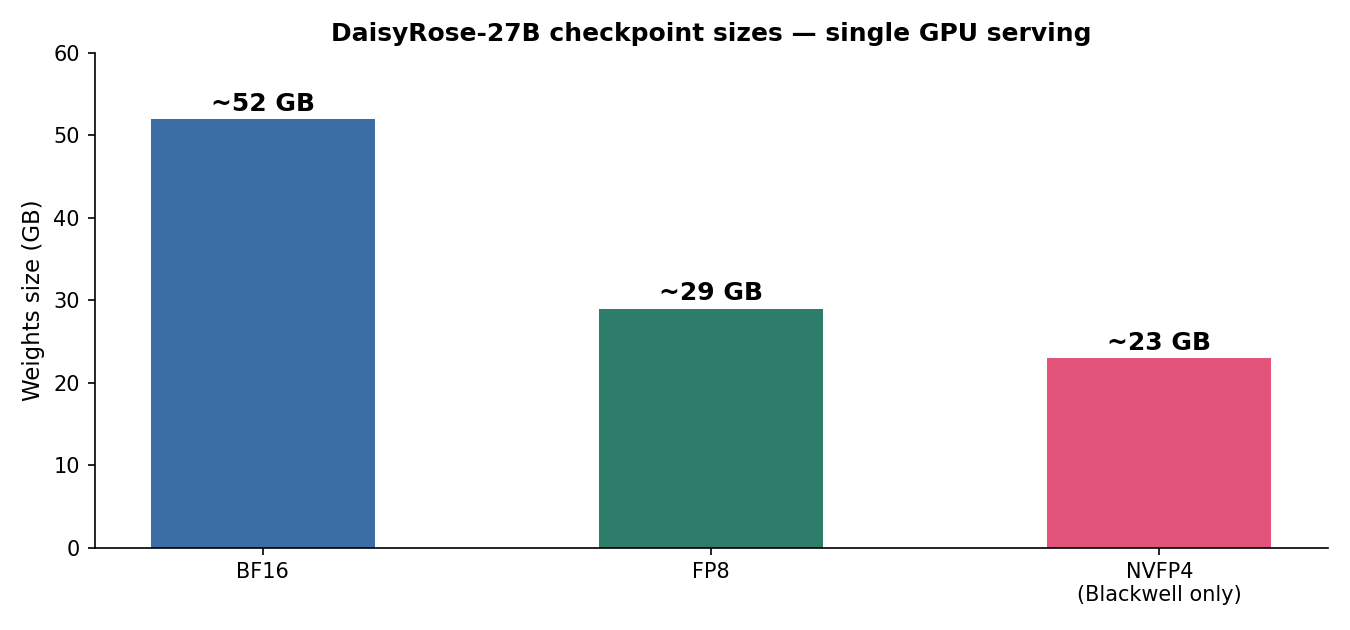
가중치는 BF16(약 52GB), FP8(약 29GB), NVFP4(약 23GB) 세 가지와 GGUF로 공개됐다. NVFP4는 Blackwell GPU 전용이다. FP8이면 29GB라 RTX 5090(32GB) 한 장에서도 여유가 있다.
공식 권장 조합은 SGLang + DSpark 추론적 디코딩이다. SGLang 쿡북에 GPU·정밀도별 실행 명령이 있다. 기본 설정은 thinking 모드(temperature 1.0, top_p 0.95, top_k 20, min_p 0, reasoning effort xhigh, max_tokens 제한 없음)다. 어려운 문제는 긴 사고가 수만 토큰까지 이어지므로 max_tokens를 걸지 말라고 안내한다.
Hugging Face에서 RadixArk/DaisyRose-27B로 바로 받을 수 있고, Qwen4-Max 가격·벤치마크 정리와 Inkling 2 Mini 오픈웨이트 가이드도 함께 보면 오픈웨이트 코딩 모델 선택 폭을 가늠할 수 있다. 토리스의 AI·개발자 도구 서비스는 /services에서 확인할 수 있다.
토리스의 판단
DaisyRose-27B는 "가장 강한 모델"이 아니라 "가장 재현 가능한 레시피"에 가깝다. SFT 없이 RL만으로, 1,200개 과제와 144개 GPU 18일이라는 현실적인 규모로 장기 에이전트 능력을 2배 올렸다는 점이 본질이다. Miles 프레임워크와 샌드박스 설계까지 오픈소스로 풀었다.
다만 실무 도입 관점에서는 냉정해야 한다. Terminal Bench 4.1의 12.0은 여전히 낮은 절대 점수고, 프론티어 모델보다 한참 뒤처진다. 주력 모델보다는 자체 모델을 RL로 특화시키고 싶은 팀이 참고할 레시피로 보는 게 맞다.
출처
광고
YOUTUBE · TORIS STUDIO
토리스 영상 더 보기
동영상
-
 코딩 에이전트를 폰으로 조종까지..오늘 깃허브를 뒤집은 오픈소스 TOP 10 (11.18 트렌딩)
-
 코딩 에이전트를 여러 개 돌리는 법까지..오늘 깃허브를 뒤집은 오픈소스 TOP 10 (11.17 트렌딩)
-
 에이전트를 앱 화면에 꽂는 법까지..오늘 깃허브를 뒤집은 오픈소스 TOP 10 (11.16 트렌딩)
-
 에이전트 토큰 확 줄이는 법까지..오늘 깃허브를 뒤집은 오픈소스 TOP 10 (11.15 트렌딩)
-
 AI 에이전트에 '스킬'을 입혀라..오늘 깃허브를 뒤집은 오픈소스 TOP 10 (11.14 트렌딩)
-
 알리바바가 사내 AI 코드 리뷰어를 풀었다..오늘 깃허브를 뒤집은 오픈소스 TOP 8 (11.13 트렌딩)
-
 클로드 페이블 5.2, 점수만 보고 쓰면 비용이 터집니다 | 에포트 High vs Max 공식 가이드
-
 오늘 깃허브를 뒤집은 오픈소스 TOP 9 (11.12) | 메타 Astryx·구글·오픈AI 깃허브 트렌딩 총정리
쇼츠
-
 구글 말고 사람들 진짜 반응 검색? 깃허브 트렌딩 2위 오픈소스 last30days 🔎
-
 프롬프트 한 줄로 3D 게임 완성? AI 앱 홀리몰리 🎮
-
 헤이젠 아바타 6, 84%가 진짜 사람이랑 구별 못 했대요 🤯
-
 구글 제미나이 태스크, 한국에서도 드디어 무료로 풀렸어요 🔥
-
 오픈AI가 GPT-6.2를 둘로 나눴어요. 아스트라와 솔, 뭐가 다를까? 🔥
-
 코딩 에이전트 여러 개를 동시에? 깃허브 트렌딩 2위 오픈소스 Orca 🐋
-
 노트북LM이 웹사이트를 만들어준다고? 제미나이 노트북 'make me a site' 🔥
-
 맥 용량 범인은 AI 모델? 로컬 모델·캐시까지 싹 정리하는 오픈소스 MangoDisk 💾